使用 LLM 时的隐私数据防护
本文起源于今天看到离离子大佬发布的 astrlink-guard 的模型,出于好奇就稍微了解一下相关的背景和一些用法。感觉发现了新大陆,之前从来没想过可以在本地 Proxy 上专门插一个模型用来做敏感消息的过滤以及模型返回时的恢复,更多是使用类似于
.env管理 key 了,使用 1password 的op run --注入进程等土方法。因此简单写一篇博客做个简单的记录。
 离离子
@Ion_Mio_
我们进一步优化了密钥过滤的准确性,降低了误报率,同时它是开源权重的,int8不到40M,CPU就能运行,可以轻松接入到您的应用中
huggingface.co/QuantumNous/astrlink-guard
1. LLM 为什么要做一些隐私数据的防护
因为我个人是做推理的,因此接触的更多是服务端的 Guardrail,比如说拦截模型输出一个极端言论了,NSFW 内容了之类的模块,这方面比较有代表性框架比如说 Nemo-Guardrail。但是在个人使用 Agent 开发中或者企业内部使用 Agent 开发中难免碰到使用外部的模型,这个时候就有很多没有太多安全意识的操作,或者是 Agent 本身的操作会将一些敏感的数据、凭证等泄露到外部。这个对于企业和个人来说把这方面数据泄露出来的成本是难以估量的。尤其是 Anthropic 等公司会肆意的分析用户数据并做一些 report,更加重了个人和企业在这个方面的顾虑。1
总结来说,做个人信息和敏感信息的 Guard 的意义在于:
- 降低个人敏感信息和公司敏感信息对外泄露给商业公司的风险。
- 中国特色国情导致开发者大量使用中转站来使用全球顶尖模型,防止个人信息以及公司敏感信息泄露给三方中转站。
2. 在哪里做隐私数据的防护呢?
从使用习惯角度,这个防护一般在个人的 AI 本地网关或者企业提供的统一 AI 网关上。个人 AI 网关比较典型的产品比如说 CC-Switch、Magpie、AstrLink 目标主要是做 Agent 和 AI Provider 之间的协议转化聚合和路由。企业聚合网关比如说 NewAPI、LiteLLM、Sub2Api 之类的,主要是管理整个公司的 LLM Provider,向内部提供多个 LLM Provider 的聚合,类似于内部的 OpenRouter。这两个组件有个共同的地方就是从 Agent 请求到 LLM Provider 之间的桥梁,因此一般可以在这个位置通过一些 Hook 增加一些专门检查隐私信息和数据的 Guard。
3. 如何做呢?
这个还是得先想清楚 Guard 要满足哪些条件。放在网关上的隐私 Guard,理想状态下要同时做到这几件事:上游拿不到敏感值;Agent 的活不受影响,该拿 key 调接口还能调;不能明显拖慢请求,也不能把上游的 prompt cache 打废;不能改坏协议,流式输出、tool call、思考签名都得照常工作;出了问题宁可拦下,也不能漏出去。
满足这些条件的做法,基本就是在网关上做一对可逆变换:请求出去之前把敏感值换成占位符,映射表留在本机;响应回来的时候再按映射表换回去。上游从头到尾只见过占位符。
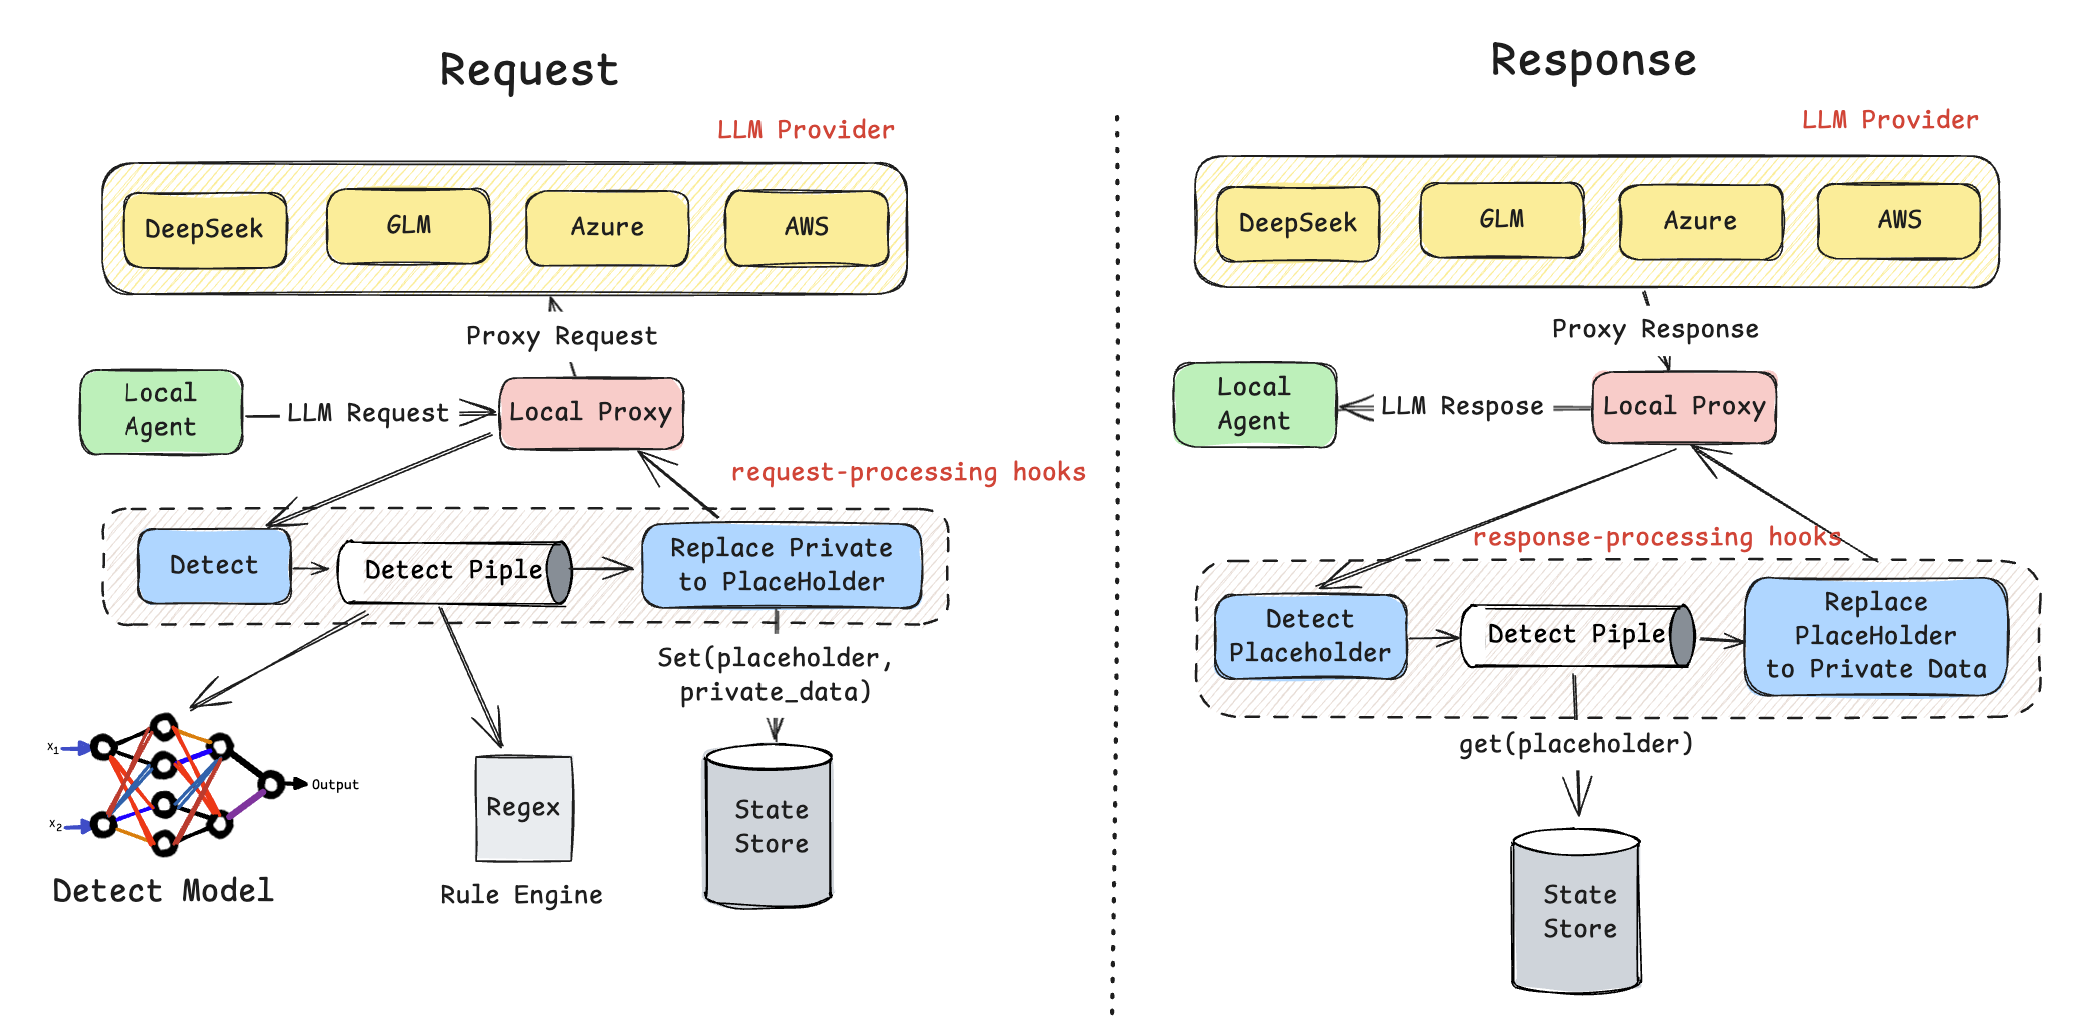
Request-Processing / Response-Processing Hook 一般网关都会有实现,如果做过后端的读者对这个两个东西应该非常熟悉,一般在后端开发里面这个过程成为 Middleware 或者 Hook。如果是伪代码大概是这样
 1async def guard_request_hook(body: bytes) -> tuple[bytes]:
 2    doc = parse_protocol(body)
 3    state_store = await get_store()
 4    for seg in doc.text_segments():
 5        spans = detect_pipeline(seg.text)
 6        for span in merge_and_filter(spans):
 7            ph = make_placeholder(span.kind, span.value)
 8            await state_store.set(ph, span.value)
 9            seg.replace(span, ph)
10    return doc.serialize()
3.1 基础实现请求
最偷懒的做法是把整个请求 body 当字符串扫一遍,但这样会出问题。一个 Agent 请求里除了用户消息,还有 model 名、tool_call_id、工具的 JSON schema,以及各家的思考签名:Anthropic thinking block 的 signature、OpenAI Responses 的 encrypted_content、Gemini 的 thoughtSignature。这些都是协议状态,下一轮要原样回传,改一个字符上游就报 invalid_encrypted_content 或者 400;tool_call_id 被改了,tool call 和 tool result 就配不上对。偏偏这些字段又是一长串高熵字符串,长得跟 key 差不多,检测器很容易误伤。
所以第一步应该是按协议(Chat Completions、Responses、Anthropic Messages、Gemini)把请求解析开,挑出真正需要检查的文本:system prompt、用户消息、助手回复、工具参数、工具结果,协议状态原样跳过。判断依据得是结构上的位置、角色和类型,不能只看字段名,不然用户在消息里贴一段 {"type":"reasoning","encrypted_content":"..."} 就能绕过检测。检测和替换都在解码后的字符串上做,替换完再重新序列化,这样也不用操心 JSON 转义。
3.2 检测 Pipeline
一般来说规则+模型:
- 规则比较适合结构化的内容,比如说 API-KEY 这种,这种其实以前扫仓库的 CI 或者 Git 的 pre-commit 中很常见(防止把 Key 暴露到仓库中),直接找个现成的正则检查库就好。
- 模型比较适合那种不太好结构化识别内容,比如人名、地址,比如说"张伟"、“王总”、“小李"没有任何固定格式,地址也可以写成"望京 SOHO 对面那个小区”,正则根本无从下手。另一类是格式完全一样,敏不敏感只能看上下文。同样是
2024-03-15,出现在日志时间戳里无所谓,出现在"我生日是 2024-03-15"里就是个人信息;同样一长串数字,可能是银行账号,也可能只是订单号。没有前缀的密码也是这样,mysql -uroot -pS3cr3t2024里的S3cr3t2024,或者聊天里随口一句"测试库密码是 qwerty2024",正则要么漏掉,要么为了抓它把一堆正常字符串也误伤了。规则看的是一个值长什么样,模型看的是它出现在什么上下文里。
模型其实之前做的很多,有判别的有生成的,很多思路都是早期做 NLP 实体抽取的方法:
- 判别式:最近的 Jev,再比如说离离子大佬开源的 astrlink-guard。判别模型也分很多种:BERT-Base 这种一开始就把标签定死了,另外是 GLiNER,实体类型在推理时以自然语言标签的形式传进去。
- 生成的比较典型的就是:gpt-oss-safeguard / Llama Guard 4,这类模型只告诉你"这条请求有没有问题",不给 span,所以只能用来提醒或拦截,做不了脱敏和还原。另外,它们的 Privacy 类针对的是"模型输出泄露别人的隐私"。比如 Llama Guard 的定义是暴露非公开的个人信息,危及某人的安全,类似人肉。这和"你自己的 API key 出现在 prompt 里"不是一回事。这种主要做服务端的 GuardRail,整个请求级别的 Guard。
3.3 Placeholder
这个东西很关键,总的来说四个方面:
- 第一是能还原,每个不同的值都要有自己的占位符。如果所有邮箱都换成同一个
<EMAIL_ADDRESS>,回来的时候就不知道哪个对应哪个了。 - 第二是稳定,同一个值在每一轮都要换成同一个占位符。一方面多轮对话里模型看到的东西要前后一致;另一方面是 prompt cache。如果每轮重新随机生成占位符,那从第一个被替换的位置开始,每一轮的前缀都和上一轮不一样,后面的 KV cache 全部失效,丢的既是钱也是首 token 延迟。
最容易想到的是按出现顺序编号,<EMAIL_1>、<EMAIL_2>,但这需要为每个会话维护一张表,而网关看到的每个请求都是无状态的,要可靠地判断两个请求是不是同一个会话并不容易,编号还会受出现顺序影响。更省事的办法是直接从值本身推出占位符,直接给 Private 数据做个 hash:
1KEY = os.urandom(32)
2def make_placeholder(kind: str, value: str) -> str:
3    digest = hmac.new(KEY, f"{kind}:{value}".encode(), hashlib.sha256).hexdigest()
4    return f"<{kind}_{digest[:16]}>"
不需要任何状态,同一个值永远得到同一个占位符。这里要用 HMAC 而不是直接哈希,因为邮箱、手机号、IP 这类值的空间不大,裸哈希可以直接枚举反推。代价是进程重启后 key 变了,所有占位符整体换一次名,cache 失效一次。
- 第三是好识别。占位符不能和正常文本撞,还原的时候才好找;最好带上类型,模型看到
<PRIVATE_EMAIL_...>知道这是个邮箱,推理不会受太大影响。
有些场景对格式敏感,比如配置文件里的 IP 字段,塞一个 <...> 进去,模型可能会觉得格式错了顺手去改。这时可以换成"长得像真的"替身,但必须来自永远不可能真实存在的保留空间:邮箱用 .invalid 顶级域,比如 [email protected];IPv4 用 RFC 5737 的三个文档网段 192.0.2.0/24、198.51.100.0/24、203.0.113.0/24;IPv6 用 2001:db8::/32。IPv4 文档网段一共也就七百多个地址,用完了就得退回标记形式。
- 第四,模型得知道这些占位符是怎么回事,这个非常非常关键。发生替换时,网关可以在 system prompt 前面加一段约定:占位符逐字节照抄,不要猜原值,不要自己对占位符做 base64 或者算长度(算出来的是占位符的,不是真值的),看到
203.0.113.7也不要当成文档示例去"修正"。AstrLink 仓库里的redaction-placeholdersskill 写的就是这些,读起来有点像在教模型怎么跟一个它永远看不见的值打交道。
3.4 Response 还原
还原这部分,推荐直接去抄推理引擎(vLLM/Sglang)或者专业 LLM 网关的 response 实现。非流式的非常好处理,甚至 find+replace 就可以做到,流式的话,因为 LLM 的 Token 的缘故,可能需要多个 Token 之后才能完整的把 placeholder 吐出来,这部分解析和 LLM Inference Engine 前端解析流式 toolcall 的逻辑基本一致,如果感兴趣的可以详细去看 Sglang/vLLM 的实现,本质上就是一个识别字符串的自动机。
网关把响应交给 Agent 之前,把参数里的占位符换回真实的 key,命令在本地照常执行。工具的输出在下一轮请求里会再过一遍检测,因为占位符是从值推出来的,同一个 key 又会变回同一个 <SECRET_9f3a1c0b7d2e4a68>,模型那边的上下文前后对得上。整个过程模型一次都没见过真实的 key,活却照样干完了。之前用 op run -- 只能保证 key 不以明文躺在磁盘上,Agent 只要 cat .env 一下,值照样进了上下文发出去;网关这层管的是发出去之前,两者可以一起用。
还原的范围也是个取舍。工具参数肯定要还原,不然命令跑不起来;最终给用户看的回复要不要还原就看需求了。还原的话用户读起来自然,但模型如果在回复里引用了 <SECRET_...>,真实的 key 也会被打印到终端和日志里。AstrLink 默认全部还原,同时在约定里要求模型别在回复里引用 secret 占位符。
4. 总结
前面讲的这套东西防的是标识符和凭证,防不住代码和业务逻辑。走中转站的时候,key、手机号、人名这些不会出去,但你的代码、项目结构、需求描述,对方照样看得到。担心的如果是这部分,只能自部署模型。
检测也不可能 100%。astrlink-guard 的模型卡里,2158 个凭证有 45 个完全没被遮住,187 条本来不含敏感信息的 coding 请求有 24 条被误报,最容易漏的是既没有字段名、也没有厂商前缀的密码。比较稳妥的用法是先开试运行看一段时间,把误报加进白名单,再切到脱敏。
位置上,同样的逻辑也可以放在企业网关里,比如 LiteLLM 接 Presidio 做 PII 掩码,配上 output_parse_pii: true 就能在响应里把掩码换回原值。区别在于放在企业网关上时,数据已经离开了开发者的电脑,只是还没出公司;放在本地网关上,数据离开本机前就处理完了。个人用本地网关更合适,企业两层都加也不冲突。
最后个人使用的最佳方式还是:Agent 常用的防护读隐私信息的土方法(settings deny、bash 工具限制)+ 网关 Guard。