DeepSeek 的 Attention 演进 -【DSA、CSA、CSA2】
Note | 前言
这是 DeepSeek Attention 演进系列的第二篇。上一篇 DeepSeek 的 Attention演进 -【MLA】 介绍了从 MHA 到 MLA 的演进,本文接着介绍 DSA、CSA 与 CSA2。MLA 解决了 KVCache 的存储形态问题,但它的计算复杂度仍是 $O(N^2)$、KVCache 仍是 $O(N)$,面对 256K/1M 的长上下文依然吃力。本文会沿着 DeepSeek V3.2-exp → V4 → V4.1-Flash 的路线,看看它如何在稀疏注意力、KV 压缩与跨层共享上,一步步把算法和工程的 Tradeoff 做到极致。
Caution | 声明
因为笔直是一时兴起写的所有难免有些笔误,尤其是词语打错了,大家放心可以帮忙纠正
1. 从 MLA 的瓶颈说起:为什么需要稀疏 Attention
注意在真实的模型中,Sparse Attention / Linear Attention 需要配合着 Full Attention 按一定比例一起使用,一般是 Full : Sparse = 1:3 / 1:4 这种混合使用的方式。
上文已经介绍了从 MHA 到 MLA 的演进,本文接着介绍 DSA 和 CSA。MLA 虽好,但是它的计算复杂度仍是 $O(N^2)$,KVCache 的空间复杂度仍是 $O(N)$,面对后续的 256K/1M 的长上下文场景还是相形见绌。因此为了解决这个困境,DeepSeek 在 V3.2-exp 版本上开始使用 DeepSeek Sparse Attention 结构作为 attention 主要的结构,用于解决这个问题。
2. Attention 的 2-8 法则:从 MLA 到 DSA
2.1 为什么稀疏可以代表大部分 feature
在预测这种文本序列的任务中,往往会发现一个现象:注意力关注点都集中在个别的词上。例如“我今天下午 7 点要去车站,我应该如何安排我的行程”,那向后预测的时候,特征需要关注的比如说“今天下午 7 点”、“行程”这种的非常高频的信号,那“我”之类的 token 就不太会对之后产生的 token 的 feature 有着信号,某些 Token 非常高频但是部分 Token 的注意力就会比较少。因此基于这个先验,我们就可以通过一个比较小的 index 网络计算出最重要的 token,然后 Attention 的时候只计算一部分重点 token 的 Attention,从而提高整体效率。
首先为了证明"重点 token"可以表示整体大部分整体的信息,我 vibe 了一个小实验统计了一下 Qwen3-0.6B 做一个简单的实验。这里先把“重点”定义为当前 Query 分配了较高注意力权重的位置。
实验本身比较简单。我准备了六段文本,分别是中文叙事、中文说明、英文叙事、英文说明、Python 代码,以及一段中文资料检索内容(差不多都是 300 个 Token)。每段原始文本直接送入模型做一次 prefill,然后记录各层 Softmax 之后的注意力权重。对于一个 Head,注意力矩阵的一行表示当前 Query 向各个可见 Key 分配了多少权重。统计方法是:对每一行的可见权重从大到小排序,然后计算保留前 $p$ 比例的位置,能够覆盖多少注意力权重。假设当前行有 $n$ 个可见位置,排序后的权重为 $a_{(1)}\geq a_{(2)}\geq\cdots\geq a_{(n)}$,定义:
$$ C(p)=\sum_{j=1}^{\lceil pn\rceil}a_{(j)}. $$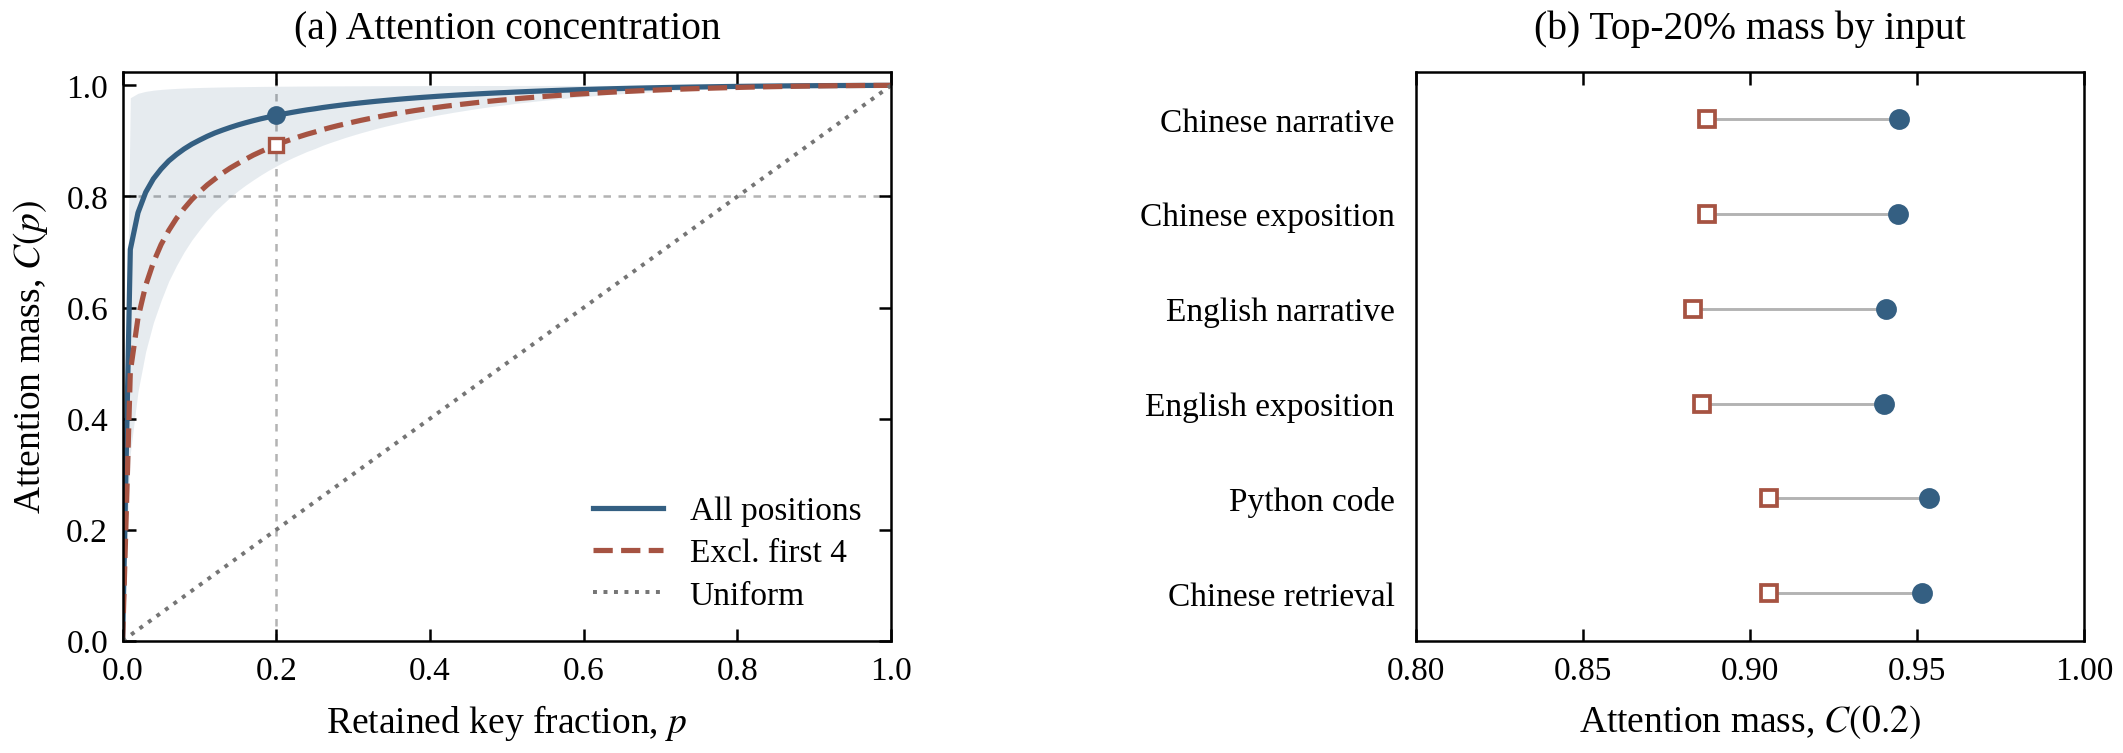
Insight | Attention 的 2-8 法则
其中我们可以观察到当 p=0.2(保留 20% 的 Attention 高频 score)的时候 $C(p)$ 在这组输入上基本都能到到 90% 以上。实践上很符合我们在计算机上常见 2-8 定律,也就是有少数关键的位置,提供了大部分信息。
2.2 Indexer+MLA=DSA
上面在说到这个现象的时候,提到可以一组 Indexer 网络,去计算高频的 Score 位置,然后 Attention 时候只 mask 这部分的 token,参与计算。如果我们设置 indexer 挑选的是 TopK 的位置,也就是 $K$ 个位置,这个时候 Attention 的计算复杂度就从 $O(N^2)$ 降低为 $O(NK)$。那么 DeepSeek 是如何设计 DSA 呢,首先我们不管主干部分,主干部分仍旧之前的 DeepSeek 的 Attention演进 -【MLA】 文章的 MLA 有详细介绍,我们看 Indexer,出于对 Attention 的理解,我们可以将 Indexer 也设计为一个精简的 Attention,只不过类似于 MLA,我们把 Indexer 的 Q/KV 压缩的更狠,维度更低,因为他需要计算的只有很粗略的相关性。下图就是 DSA 的 Indexer 结构,其实像一个微型的 Attention,不过出于计算的吞吐考虑1,并没有选择传统的 Softmax 方式去计算分数,而是直接使用 ReLU+head weight 的方式直接计算。选择 ReLU+weight 有两个原因:
- 在最终分数后加 Softmax,对 Top-k 没有帮助:同时又是因为只需要输出 index,因此也不用做归一化,直接 argmax 取 index 即可。
- 每个头用 ReLU,比每个头做 Softmax 更容易高效计算:这就不说了 ReLU 就是一个简单的分段函数,而 Softmax 需要计算超越函数。
Note | 训练用 Softmax,推理用 ReLU
注意在实际训练中其实还是用 softmax,但最终会用 KL 做一个对齐2,推理的时候完全使用 ReLU+weight
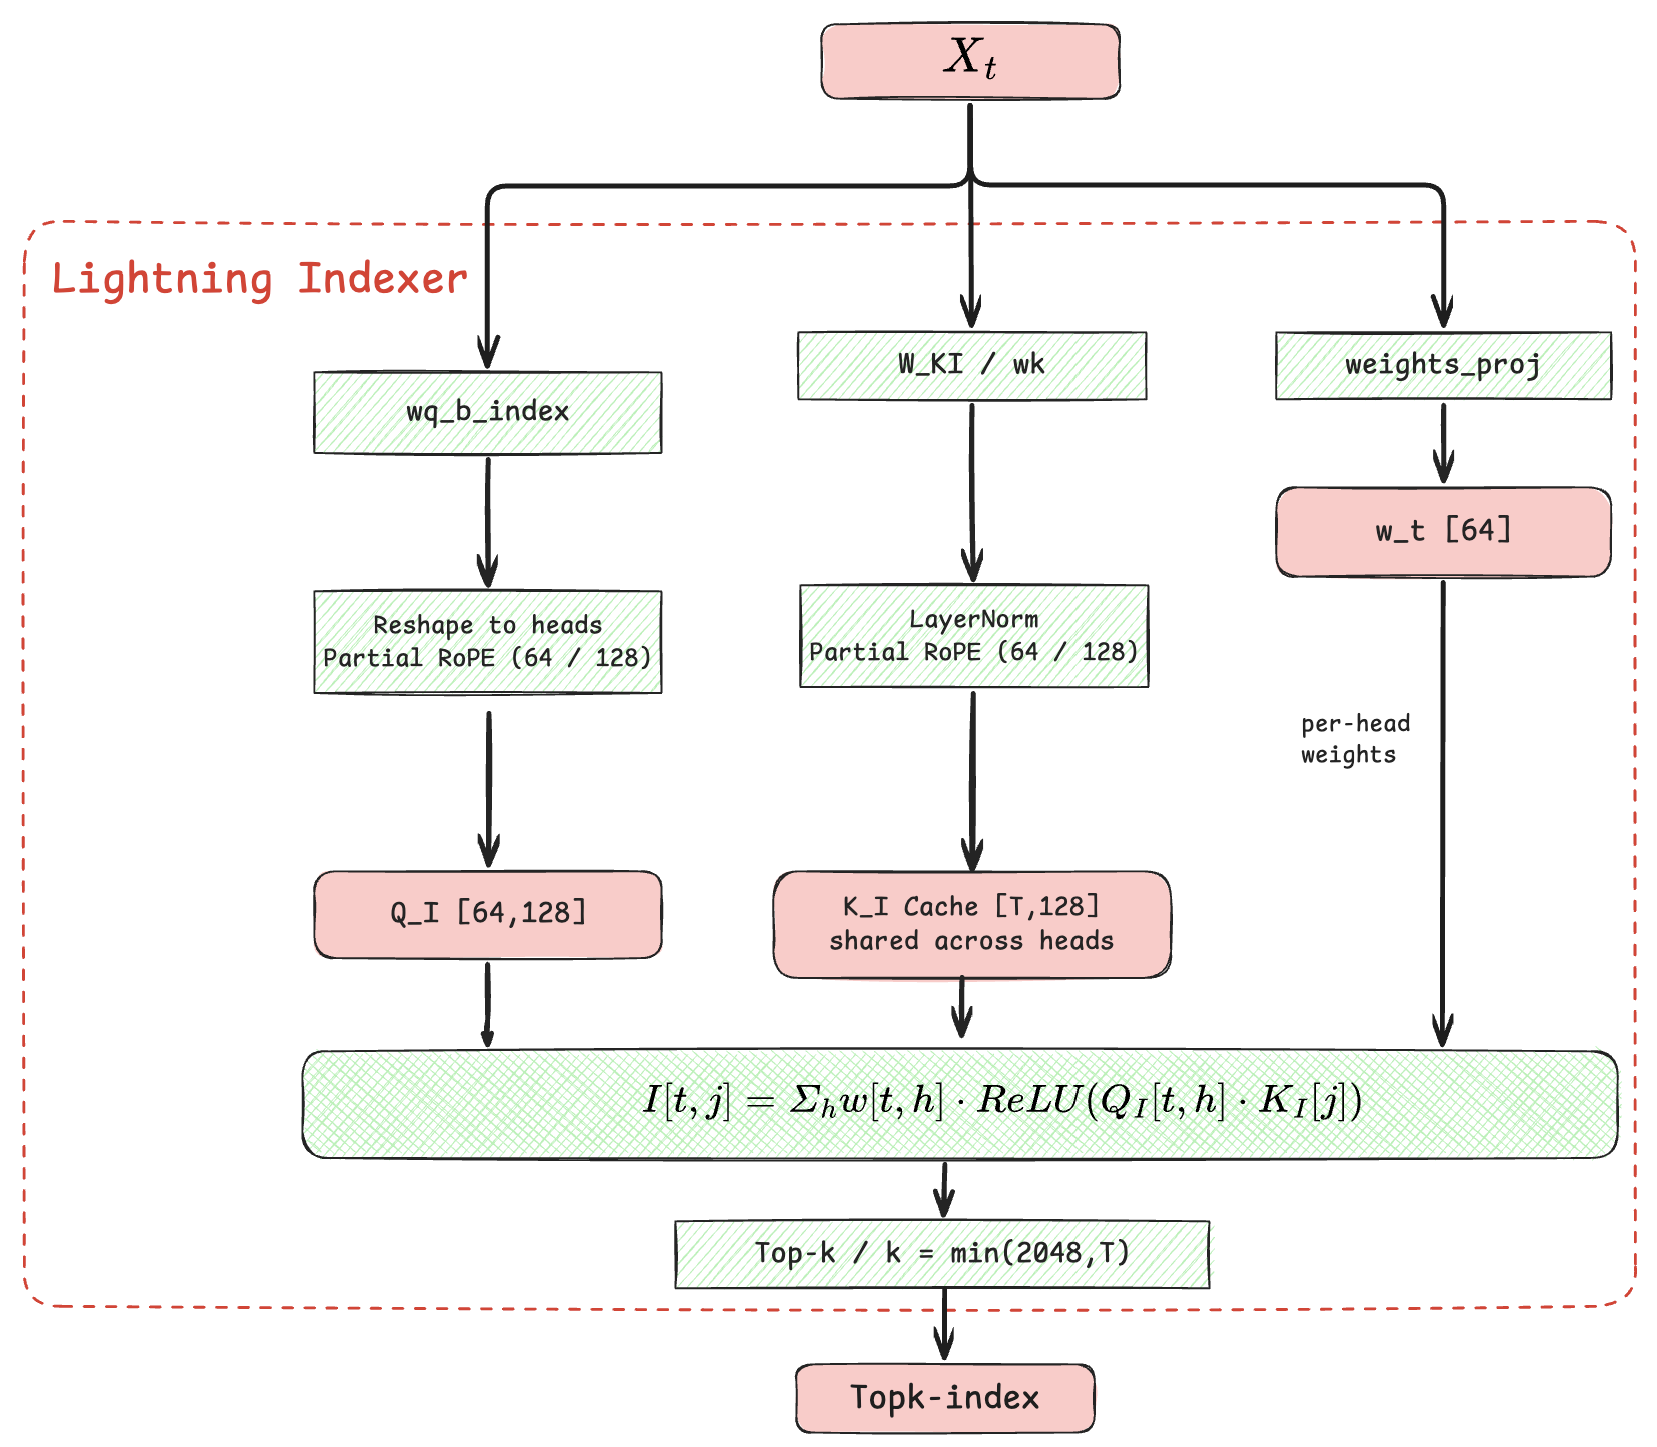
该结构在 DeepSeek Sparse Attention 中称为 Lightning Indexer。
接上之前的 MLA 整体的结构为 DeepSeek Sparse Attention(DSA):
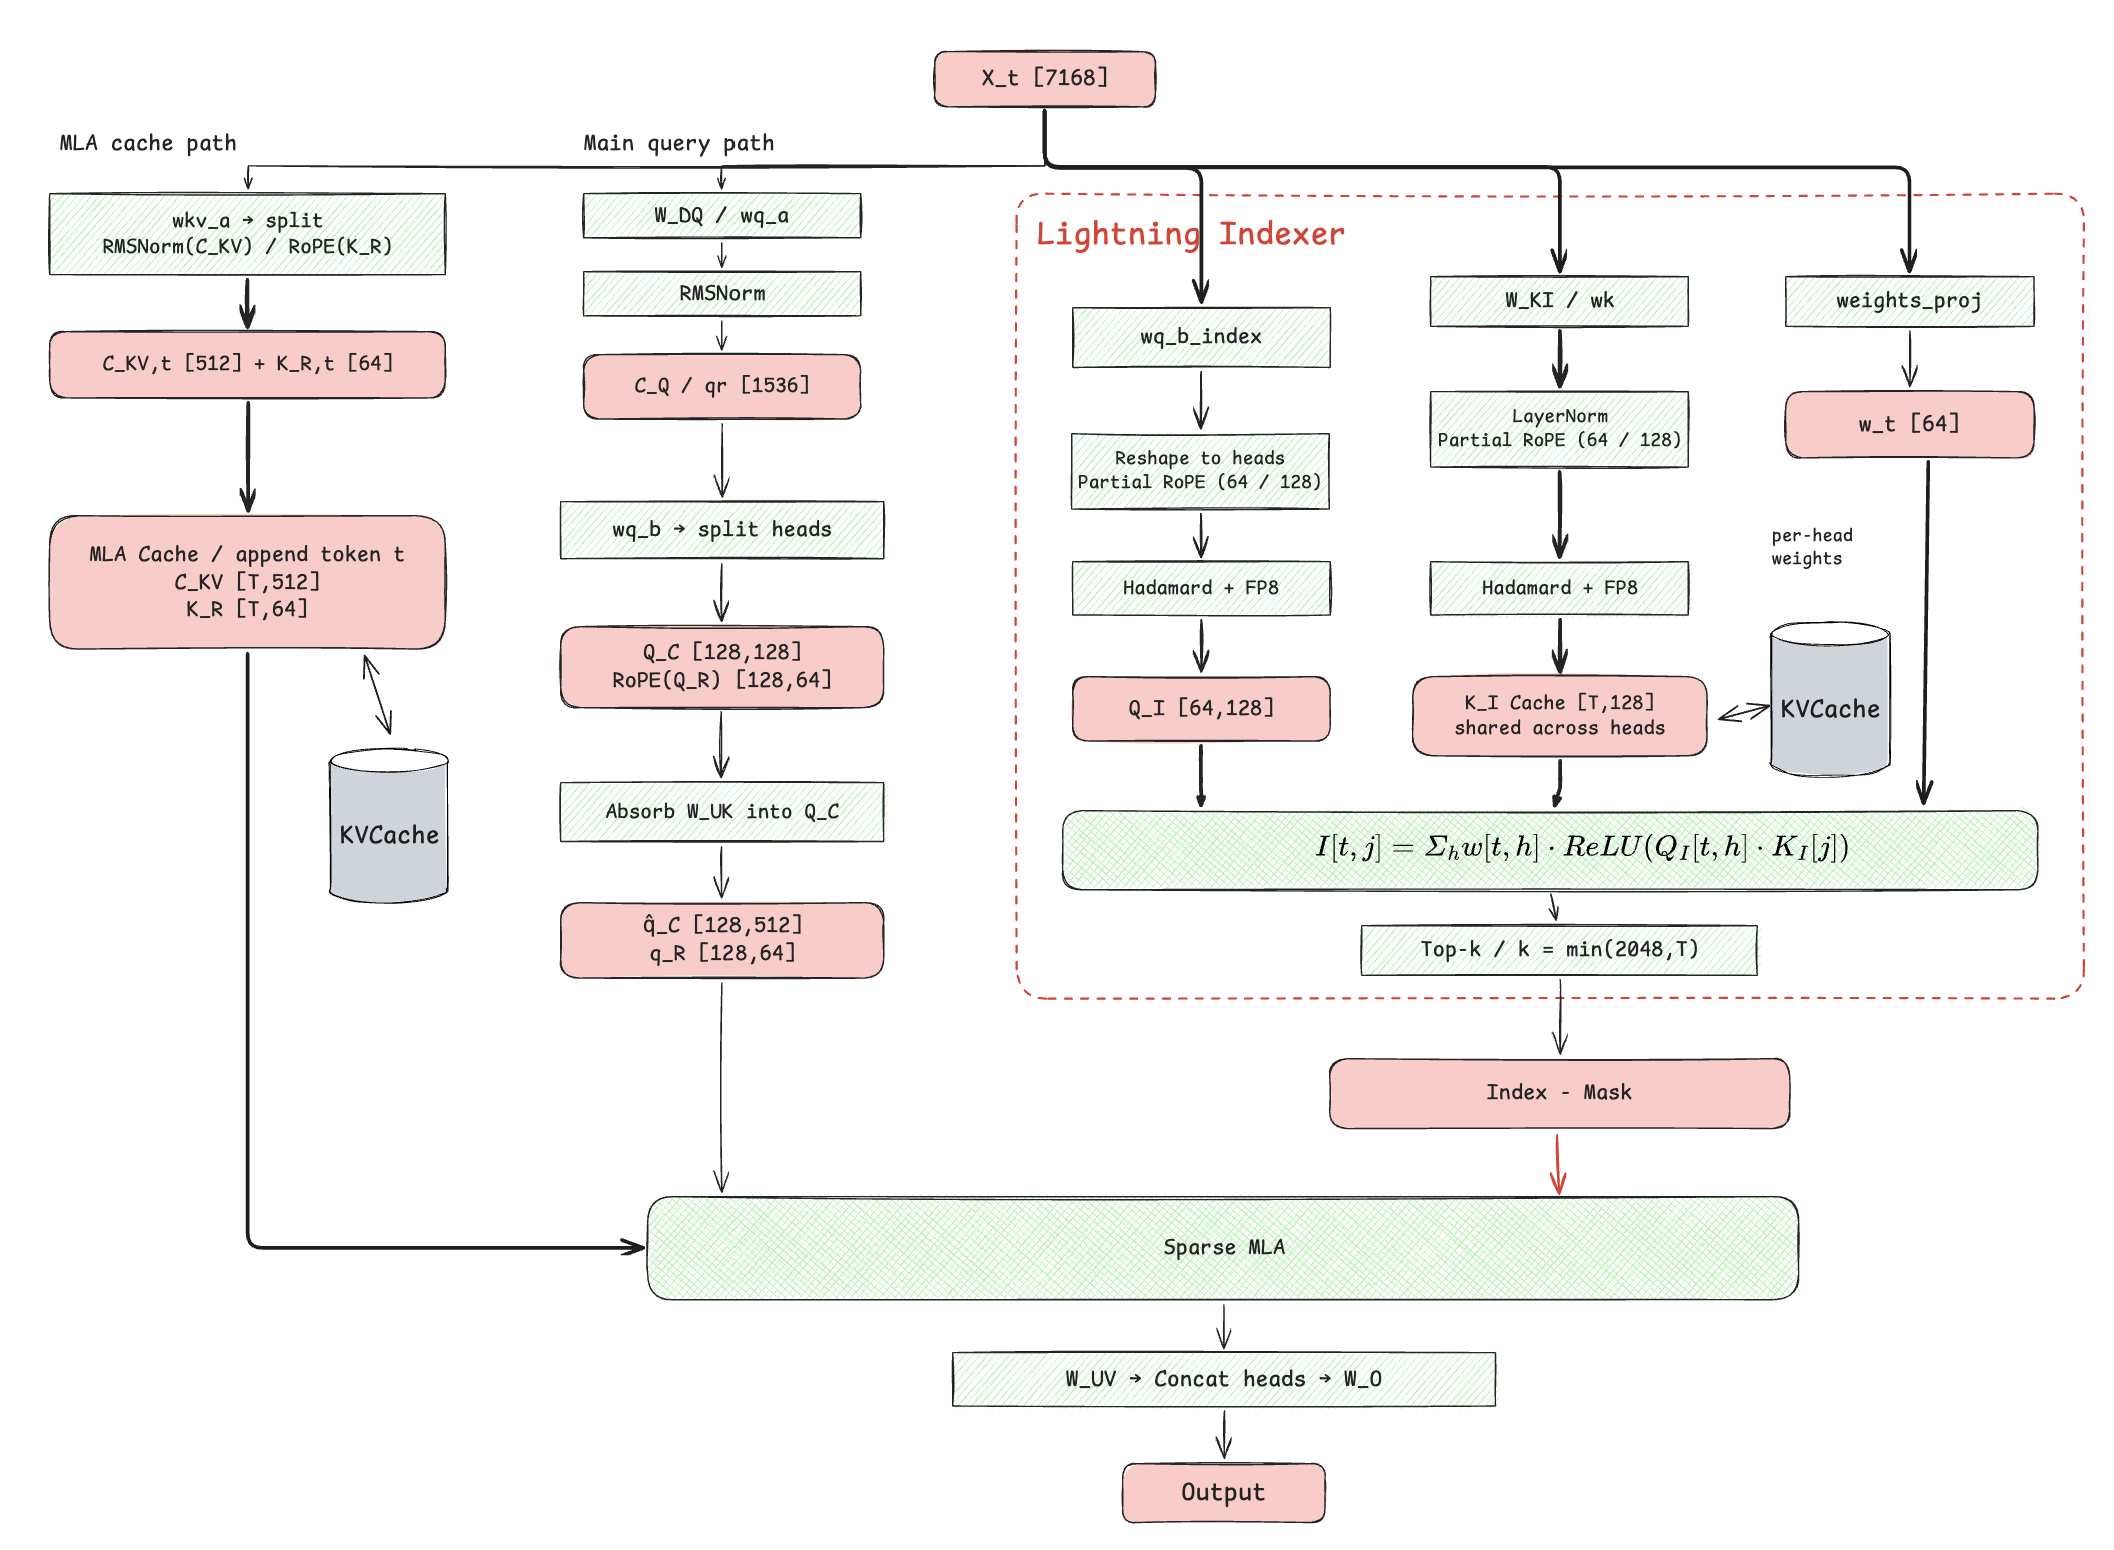
其中对比之前的链路在 $K_I$ 这步增加了一个 KVCache 位点。
2.3 Kernel优化:算法的理想与工程的现实
我们乍一看 DSA 思想上还是算法上都是能提高效率,但是实际上从工程实现上有很多难点比如说:
- Top-k 传统
torch.topk实现的过于低效拖慢了整个实现。 - Sparse MLA 在短上下文/低并发性能并没有 Dense MLA 性能好,但在长上下文中,因为 $K \ll L$ 从算法角度都会远远优于之前的 MLA。
为了解决 Top-K 带来的问题,后续有很多工程方法进行了解决,包括 Radix-select-based Top-K3, Guess-Verify-Refine4 ,DeepSelect5 都是在解决 Top-k 低效的问题,这里不再赘述,后面可以单开一篇专门讲一下 Top-K 的问题。
对于 Sparse MLA 其实本质还是 Sparse MQA 和 Sparse MHA 的 Kernel,因为 MLA 有两个计算形态6,这个在之前的博客里面介绍过。但是整体来说因为 $K$ 的固定开销和稀疏索引的问题,其在短上下文和低并发下 SM 并没有得到很高的利用率7,flashMLA 的 blog 也提到这个问题。为了解决稀疏和 $K$ 的问题,比如说 trtllm 会在小上下文下使用跳过 indexer 计算的方式,vLLM 还有 sglang 也都实现了这种做法8,而且是默认开启。
经过这么久的优化 DSA 的整个结构在性能上已经非常到位了,而且广泛用在其他别的比较流行的模型上,比如说 GLM5.x 系列以及 MinimaxM3 以 DSA 为基础魔改的 MSA9。
2.4 跨层的 Attention 的位置是否可以一致:IndexCache
在看过 DSA 为代表的 sparse attention 的思路,那跨层的 Attention 是否存在重点 Token 一样的情况呢?其实是有的,GLM 测量他们 DSA 相邻层的 Indexer 选择的 token 位置发现 70% 都是一样的10。
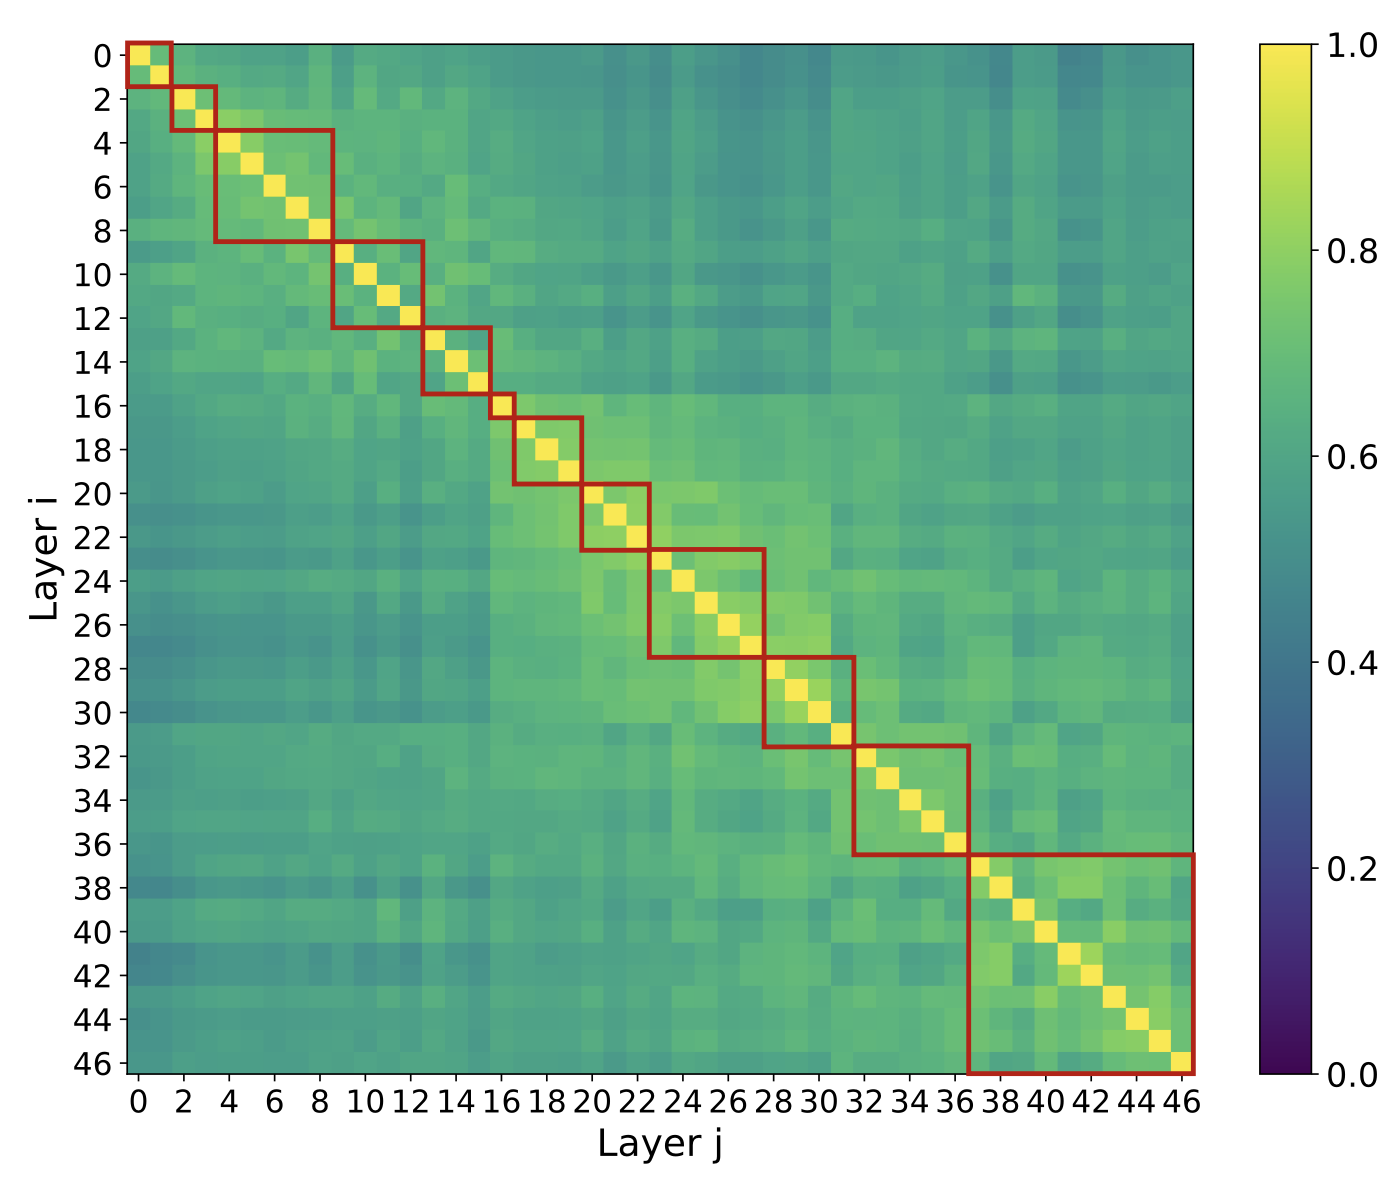
因此 GLM 开发出了另一个加速的方式,既然 Topk 比较慢,那就通过测量层和层之间的相似度,将相似的层的 index 缓存下来,这样选择相同 Token 的层就可以直接共用一个 Indexer。当然这种方式需要一定的微调,因为相近的层只是相似,需要一定的微调把相近的层的 Indexer 微调到一致。通过缓存 Indexer,大概可以得到 1.5-2x 的速度提升。这个优化方式广泛的使用在 GLM5.x 的模型系列。
3. SlidingAttention 与 SparseAttention 的结合:CSA 的诞生
经过对上文的叙述,想必读者已经对 DSA 有所了解,DSA 解决了长上下文的计算负担,但是没有解决 KVCache 的压力,因为 Indexer 的原因,反而增加了一个 KVCache 的位置,略微增加了 KVCache 存储压力。
Important | 降低的是存储压力,不是传输压力
这里提到的是没有降低 KVCache 的存储压力,而不是计算的时候 KVCache 的传输压力,这个在 DSA 中已经得到了解决,因为 Indexer 只会选择 TopK 位置,load KVCache 的压力是一个常数。
DeepSeek 在 V4 版本中提出了两个结构去解决上述 KVCache 的问题:
- Compressed Sparse Attention(CSA): Sparse Attention + Sliding Attention + KVCompressor 的组合
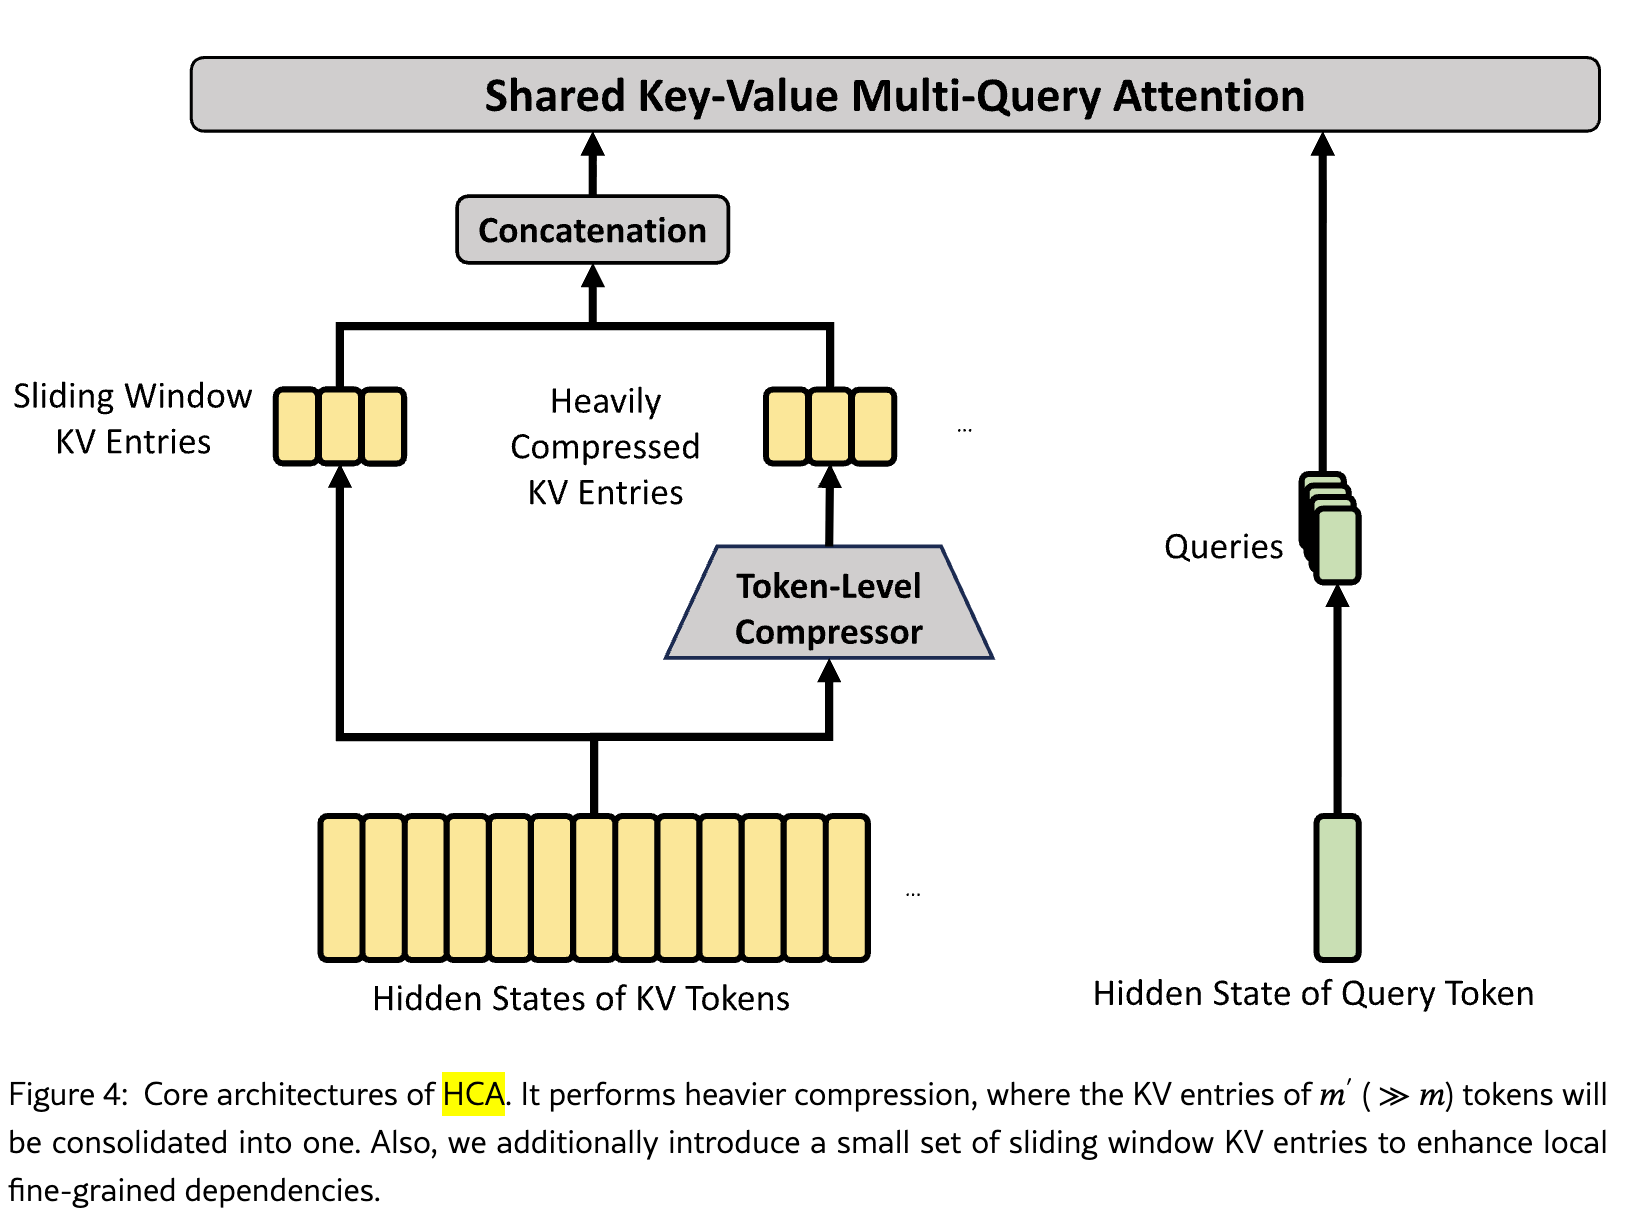
- Heavily Compressed Attention(HCA): 极致的压缩 KVCompressor 之后直接跟 MQA。
两个的组合就像 HCA 负责全局摘要,压缩率更极致,CSA 负责做更精细的粗读+精读。
为了增加压缩 KV 的方法,DeepSeek 首先引入了 Compressor 结构,这也是 CSA 的核心。通过类似池化+Gate 的方式将多个 Token 压缩为一个,从而降低整体的 KVCache 的存储压力。
3.1 对 KV 的 Gate 池化:Compressor
本身这个结构并不复杂,如果读者对 DeepLearning 比较熟悉的话他其实就是一个 Gate 的 Pooling,如下图所示:
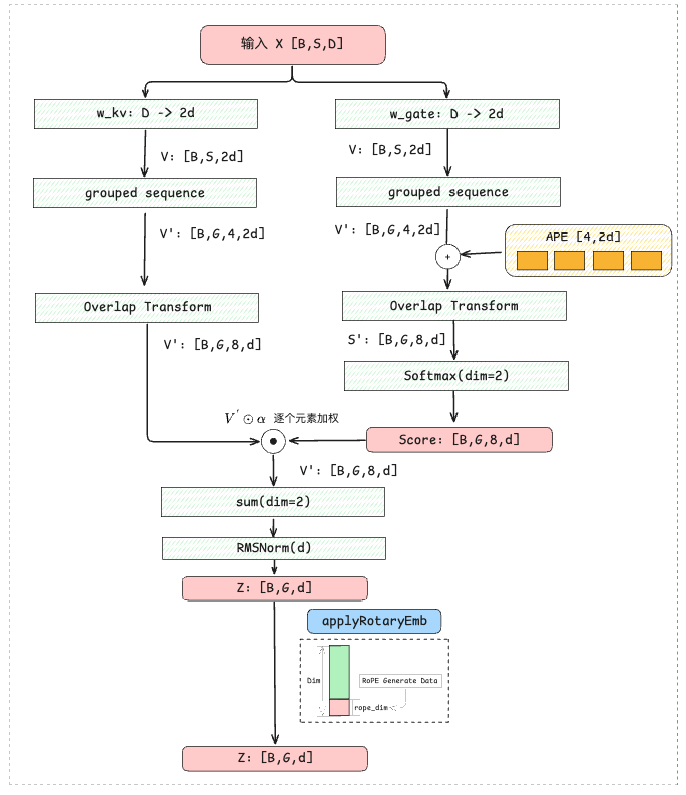
首先将 X 先做一个映射,然后按压缩率进行分组,上文展示的每 4 个 Token 压缩为一个,因此 $V'$ 的维度是 $[B,G,4,2d]$ 其中 $G = S/4$。Gate 因为要计算这 4 个 token 组合权重,因此 Gate Path 也需要做同样的映射。
Overlap Transform 也是很关键的操作,他类似于我们在 RAG 中常用的 slice overlap 的方式,下一个片段的信息需要和上一个片段的范围有覆盖,从而达到让单个 Token 的视野更多。整体的思路是之前 $2d$ 切分为上半段和下半段,上半段每个都取前一个 group 的上半段,然后与当前的后半段交叉在一起。如图所示:
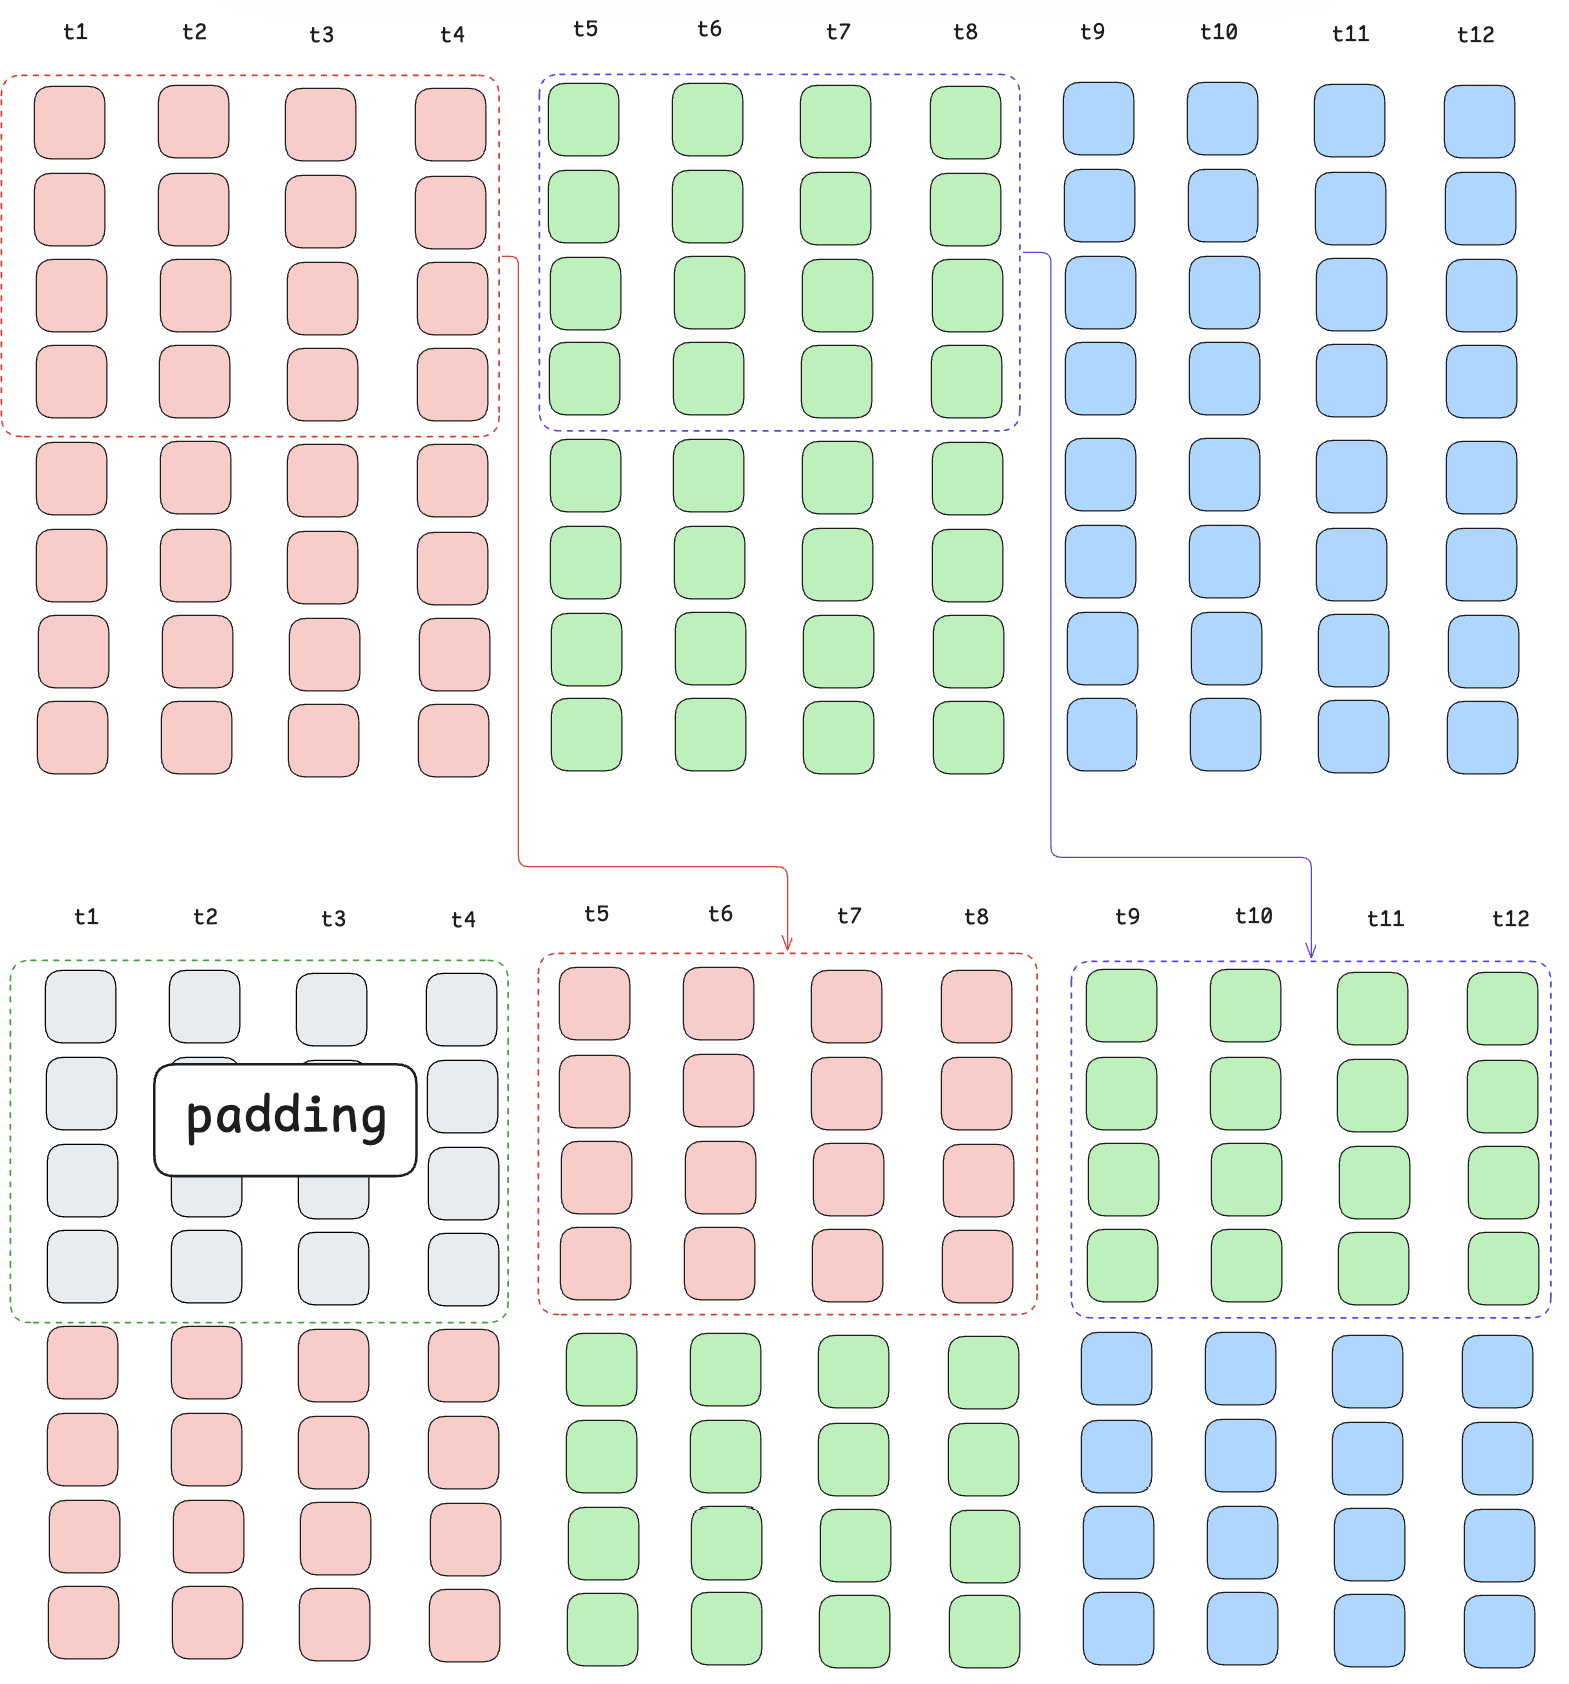
$[t1,t2,t3,t4]$ 为一个 group1,$[t5,t6,t7,t8]$ 为 group2,group1 的上半部分 $d$ 的向量平移到 group2 的上半部分。因为 group1 的上半部分已经平移走了,因此他需要将所有数值置为 $-INF$,使用 Pytorch 可以表示为这样
 1def overlap_transform(x: torch.Tensor, pad_value=0.0) -> torch.Tensor:
 2    # x: [B, G, m, 2*d], m=4
 3    B, G, m, two_d = x.shape
 4    d = two_d // 2
 5    out = x.new_full((B, G, 2 * m, d), pad_value)
 6
 7	# up d-dimension
 8    out[:, :, m:, :] = x[:, :, :, d:]
 9
10	# down d-dimension
11    out[:, 1:, :m, :] = x[:, :-1, :, :d]
12
13    return out
14
15# KV Path Overlap
16kv_overlap = overlap_transform(kv, pad_value=0.0)
17# Gate Path Overlap
18logits_overlap = overlap_transform(
19    gate_logits + ape,
20    pad_value=float("-inf"),
21)
这个在 HCA/CSA 这两个结构中有这两个不同11:
- HCA 的 KVCompressor 的 m=128,同时不做 overlap。做极致的压缩,而且不考虑前后的关系。
- CSA 的 KVCompressor 的 m=4,同时做 overlap。做比较粗略的压缩,但是细节关注比较多。
3.2 局部性原理:SlidingWindowAttention与SparseAttention的结合
人阅读的时候,我们大脑是对最近刚读完的一些字母/单词更熟悉的,对很过去的内容只有一个大概的印象(压缩的信息)。DeepSeek 的 CSA 也构造了一个类似这样的机制,使用滑动窗口的方式,对最近的 128 个 token 做全量的无压缩的 Attention,而对 128 个 token 前的内容使用上面提到的 KVCompressor + SparseAttention 的方式做压缩和选择性的进行 Attention。与 DSA 的对比如下图所示:
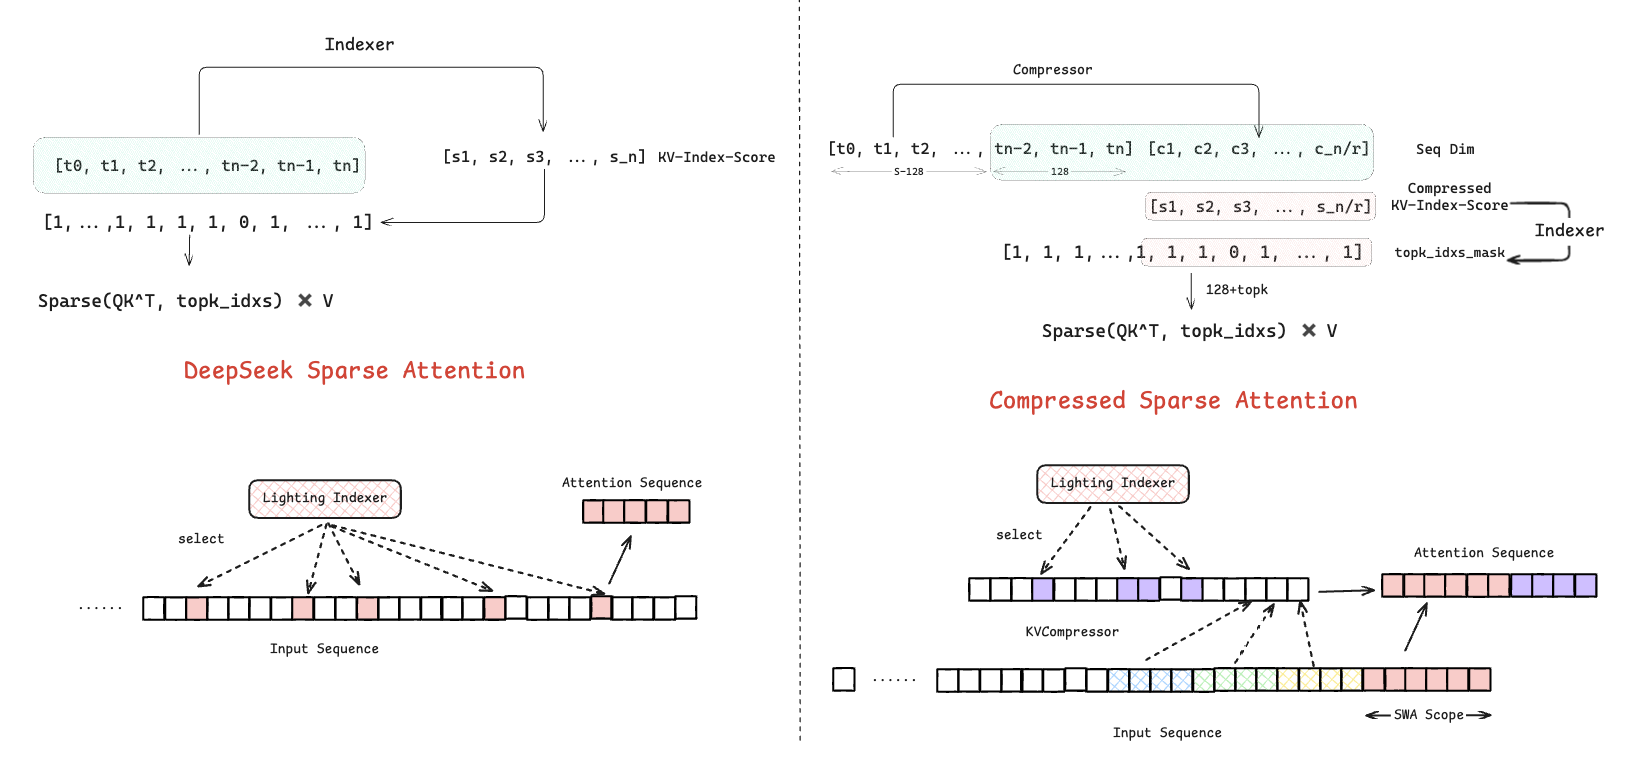
DSA 的时候,DeepSeek 通过 Indexer 去计算最与当前信息相关的 topk(2048) 个 Token,而在 V4 的 CSA 结构中:
- 首先将 128 个 Token 完全包括在最终要算法的 Attention 序列中
- 对 $S-128$ 个 Token 使用 KVCompressor 进行压缩
- 对压缩后的 Token 使用 indexer 选择最相关 topk 的信息。
- 根据 128 个末尾 Token 和 Indexer 产生的压缩 Token 索引,最终产生一个总体的 mask,投入 Sparse Attention 中完成计算。
这种方式既兼顾了近处的信息,也获取长程的压缩信息,更核心的是通过 KVCompressor 我们只需要缓存最近 128 个 Token 的 KV 和 KVCompressor 压缩后的 KV 即可,大大降低了 KVCache 的存储压力,这里面我做了一个简单的表格来对比 KVCache 的差距(忽略局部窗口、压缩状态和量化元数据的占用)
| 架构 | 主注意力缓存 | Indexer 缓存 | 合计元素/token | 相对 MLA |
|---|---|---|---|---|
| 原始 MLA | 512+64=576 | 0 | 576 | 100% |
| V3.2 的 DSA | 512+64=576 | 128 | 704 | 122.2% |
| V4 的 CSA,m=4 | 512/4=128 | 128/4=32 | 160 | 27.8% |
Insight | CSA 同时解决了复杂度和 KVCache
可以看出对比 MLA 和 DSA,CSA 既解决了 MLA 对长程计算的计算复杂度问题,又将 KVCache 占用压缩到之前的 1/4 左右。
3.3 State Cache:Decode 时需要保留的短时状态
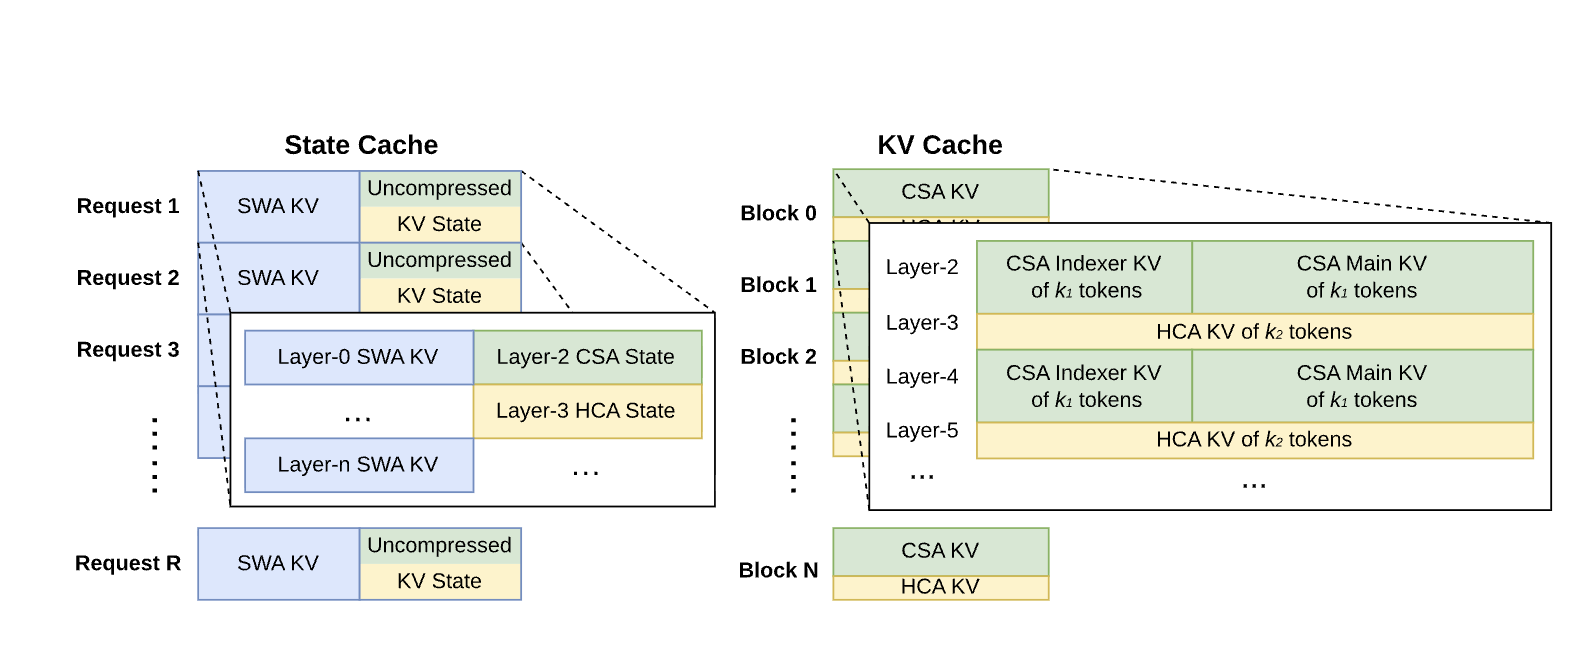
除了长程的 KVCache 以外,V4 的 CSA 结构也引入 StateCache。State Cache 是模型为了继续处理下一个 token,需要保留并不断更新的一小段状态。 在 V4 里,它主要包括局部窗口的 KV,以及压缩器尚需使用的中间状态。主要分为两部分:
- Sliding Window 的 KV:因为 Sliding Window 在计算中一直在更新(常数空间),且不需要保存历史状态
- KV-Compressor 的状态:沿用刚才的
m=4、overlap=True:
上一组:token 0、1、2、3
当前组:token 4、5,尚缺 6、7
此时压缩器需要保留:
- 当前未完成组的投影结果和 gate logits,等 6、7 到来后一起计算。
- 上一组用于 overlap 的表示和 gate logits,因为下一条压缩 KV 要聚合上一组与当前组的信息。
我们可以这样分析两个 Cache:
| 缓存 | 保存什么 | 随历史长度增长? |
|---|---|---|
| 历史压缩缓存 | 已经生成的压缩 KV、对应的 Indexer Key | 会 |
| State Cache | 最近窗口的 KV、压缩器的工作状态 | 单个请求、单层的容量固定 |
Insight | State Cache 的定位
State Cache 主要是计算时候引入的短时状态,不需要保存整个历史的逐 token KV。
3.4 Heavily Compressed Attention:极致压缩 + MQA
HCA 就是一个相对非常简单的结构,与 CSA 类似是用滑动窗口 Attention + Compressor 结构的结合,滑动窗口选择 128 Token 为窗口,Compressor 直接做极致的压缩(128 个 token 压缩成 1 个 token),然后 concat 之后直接做 MQA。
3.5 CSA 与 HCA 的堆叠:V4 的整体组织
在整体的结构中 DeepSeekV4 采用 HCA 和 CSA 堆叠的方式进行组织,V4Pro 和 V4Flash 采用不同的堆叠方式:
- V4Pro 最开始两个是 HCA,后续是 CSA+HCA=1:1 堆叠
- V4Flash 最开始是 SWA,后续是 CSA+HCA=1:1 堆叠
4. CSA2:更极致的压缩和共享
经过上面的介绍,我们可以发现 CSA 主要是在序列维度上压缩 KVCache,把多个 Token 的信息合并成一个条目。但从整个模型来看,每层仍然需要维护自己的缓存。即使单层压缩得很好,乘上几十层之后,整体的存储压力仍然不小。
前面介绍的 IndexCache 已经说明,相邻层选择的重点位置存在相似性,因此可以复用 Top-K 的结果。CSA2 在这个方向上继续推进,把主 Attention 的 KV、Indexer 的 K,以及 Top-K 索引都纳入跨层复用的范围。同时配合 CED,让 Decoder 的全局 KV 从 Encoder 的输出生成,进一步降低长输入的处理开销。
4.1 Compressor 的简化:去掉 Overlap,共用压缩结果
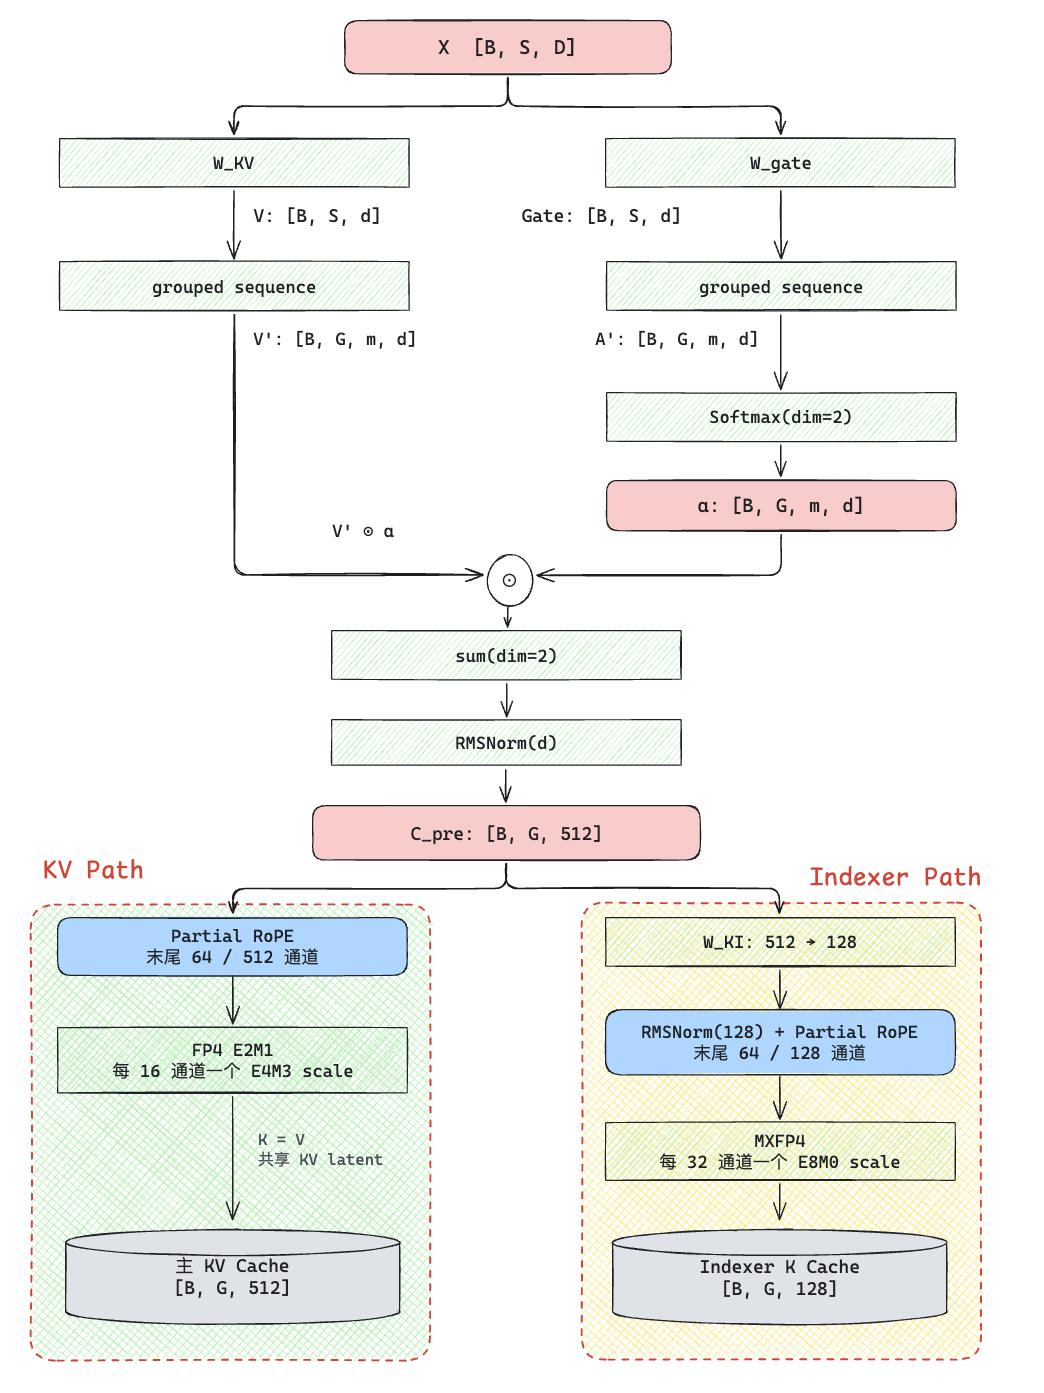
首先看 Compressor。CSA2 仍然使用 Gate Pooling,将连续的 m 个 Token 聚合成一个 KV 条目,不过去掉了原先的 Overlap Transform 和压缩器内部的 APE。因此,参与一次压缩的范围从跨越两组的 2m 个 Token,变成当前组的 m 个 Token12。
Note | 与 CSA 的维度对照
Overlap Transform 会将 $[B,G,4,2d]$ 的维度展开为 $[B,G,8,d]$,因此可以认为是压缩了 2m 个 Token,CSA 不再将 $X$ 映射为 $2d$ 维度,而是直接映射为 $d$,维度跳过了 overlap 这一步
沿用前面的符号,忽略末尾尚未完成的分组,可以写成下面的示意代码:
1# x: [B, S, d_model],这里简化一下 S 可以被 m 整除
2kv = kv_proj(x).reshape(B, S // m, m, d)
3gate = gate_proj(x).reshape(B, S // m, m, d)
4
5# 每个通道分别计算组内 m 个 Token 的权重
6weight = gate.softmax(dim=2)
7compressed_kv = kv_norm((kv * weight).sum(dim=2))
8# compressed_kv: [B, S // m, d]
另外一个变化是在 Indexer 上,CSA2 直接从尚未应用 RoPE 的压缩表示投影出 Indexer K,省去了独立的 Indexer 压缩路径。之后,主 KV 和 Indexer K 再分别进行位置编码与量化。也就是直接将 KV 和 Indexer 共用一个 Compressor。整体的结果如图所示:
4.2 CSA2 的整体流程:局部窗口 + 全局检索
把 Compressor 接回主干,CSA2 仍然保留了前面介绍过 CSA 的基本思路:
- 本层维护最近 128 个 Token 的局部窗口 KV。
- Indexer 从因果可见的全局 KV 中选择最多 512 个条目。
- 主 Query 同时关注选中的全局条目和局部窗口,得到本层的 Attention 输出。
下面展示执行完整计算流程的 Full Mode。图中的维度采用 V4.1-Flash 的实际配置:主 Query 有 64 个 Head,每个 Head 为 512 维;Indexer 有 32 个 Query Head,每个 Head 为 128 维。如图所示:
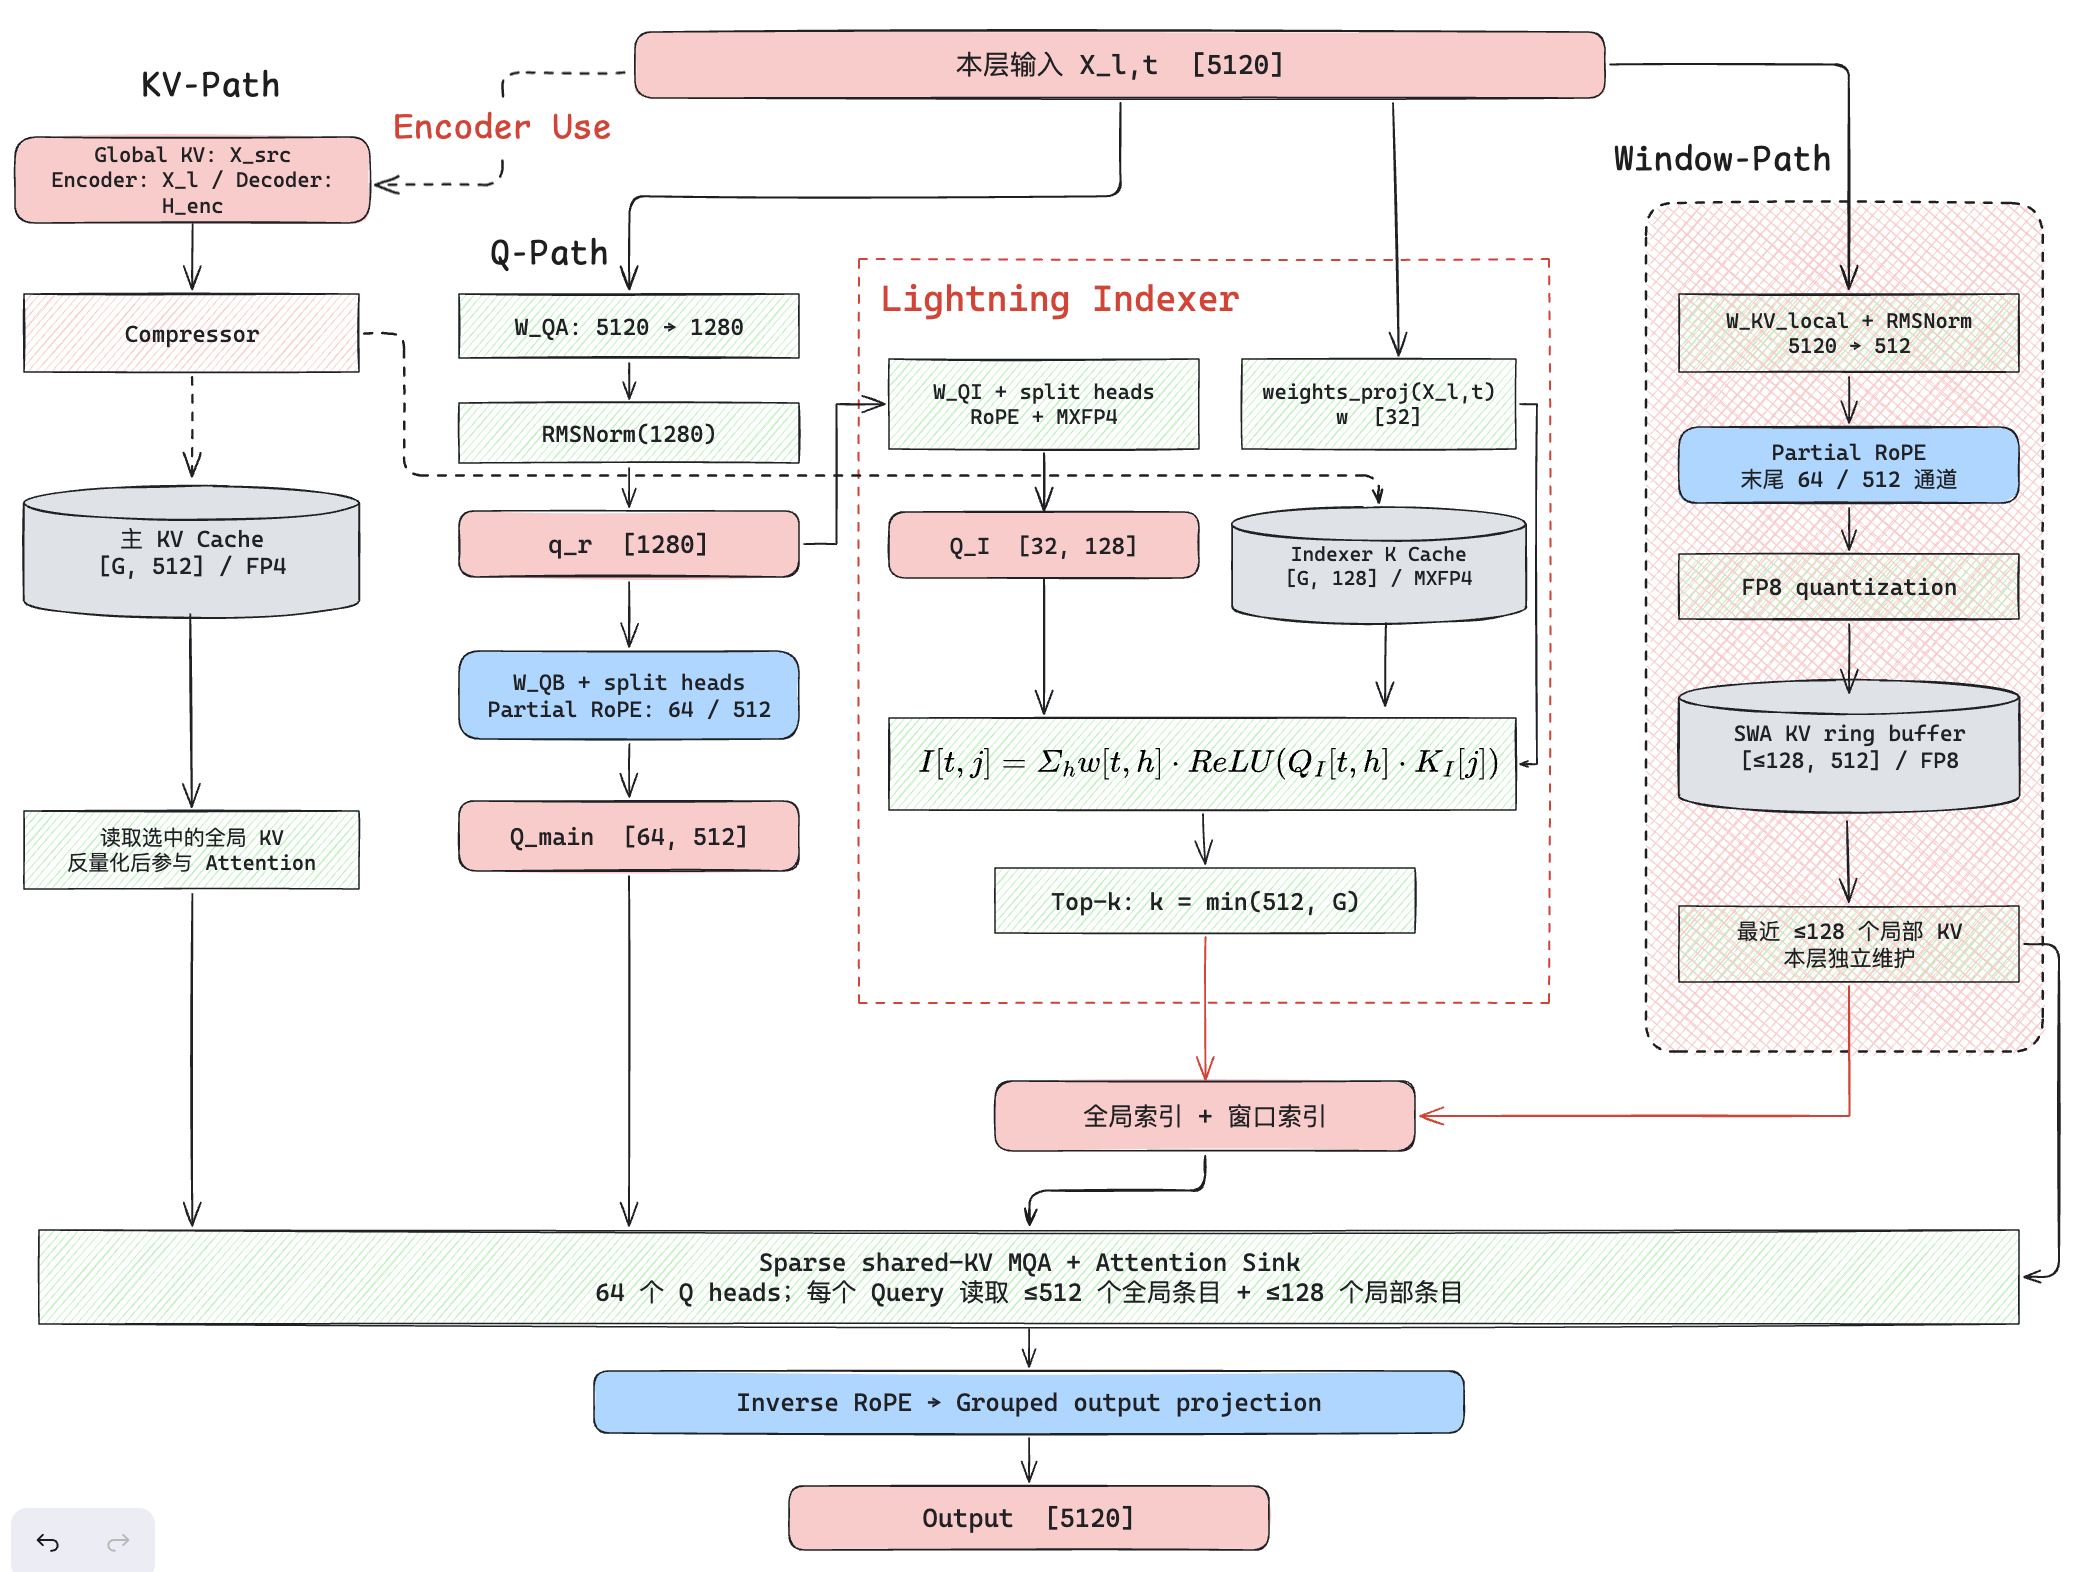
整体 Path 有四个部分:
- KV-Path:直接获取压缩后被压缩后的 KV 序列。Attention 的时候会通过 indexer 得到的 mask 进行掩码。KV 的输出有两种可能:
- 在 Encoder 部分,直接使用本层的输入
- 在 Decoder 部分直接使用的 $H_{enc}$ 也就是 Encoder 的输出。
- Indexer:这个部分同 CSA 和 DSA 用于找到与当前压缩后的 KV 最重要的 topk 的 token。这个和 CSA 不同,CSA 的 Indexer 的 K 是单独的一个 Compressor 之后做计算的,而 CSA2 的 Index K 是直接共用 KV Compressor 的输出的。
- Q-Path:计算 Query 信息。
- Window-Path:这部分用于产生最近 128 Token 的 window 部分信息。
4.3 从 IndexCache 到 KVCache:三种跨层共享模式
前面的 IndexCache 主要复用“看哪些位置”的结果,而 CSA2 进一步把“这些位置对应的内容”也共享起来。
为了让共享保留一定的灵活性,CSA2 将各层静态配置为三种模式:
| 模式 | 全局主 KV 与 Indexer K | Top-K 索引 |
|---|---|---|
| Full | 本层生成 | 本层重新计算 |
| Reindex | 复用前面 Full 层的缓存 | 用本层 Indexer Query 重新计算 |
| Reuse | 复用前面 Full 层的缓存 | 复用针对这份缓存产生的最新索引 |
论文中有一张图很好的表示这三种模式
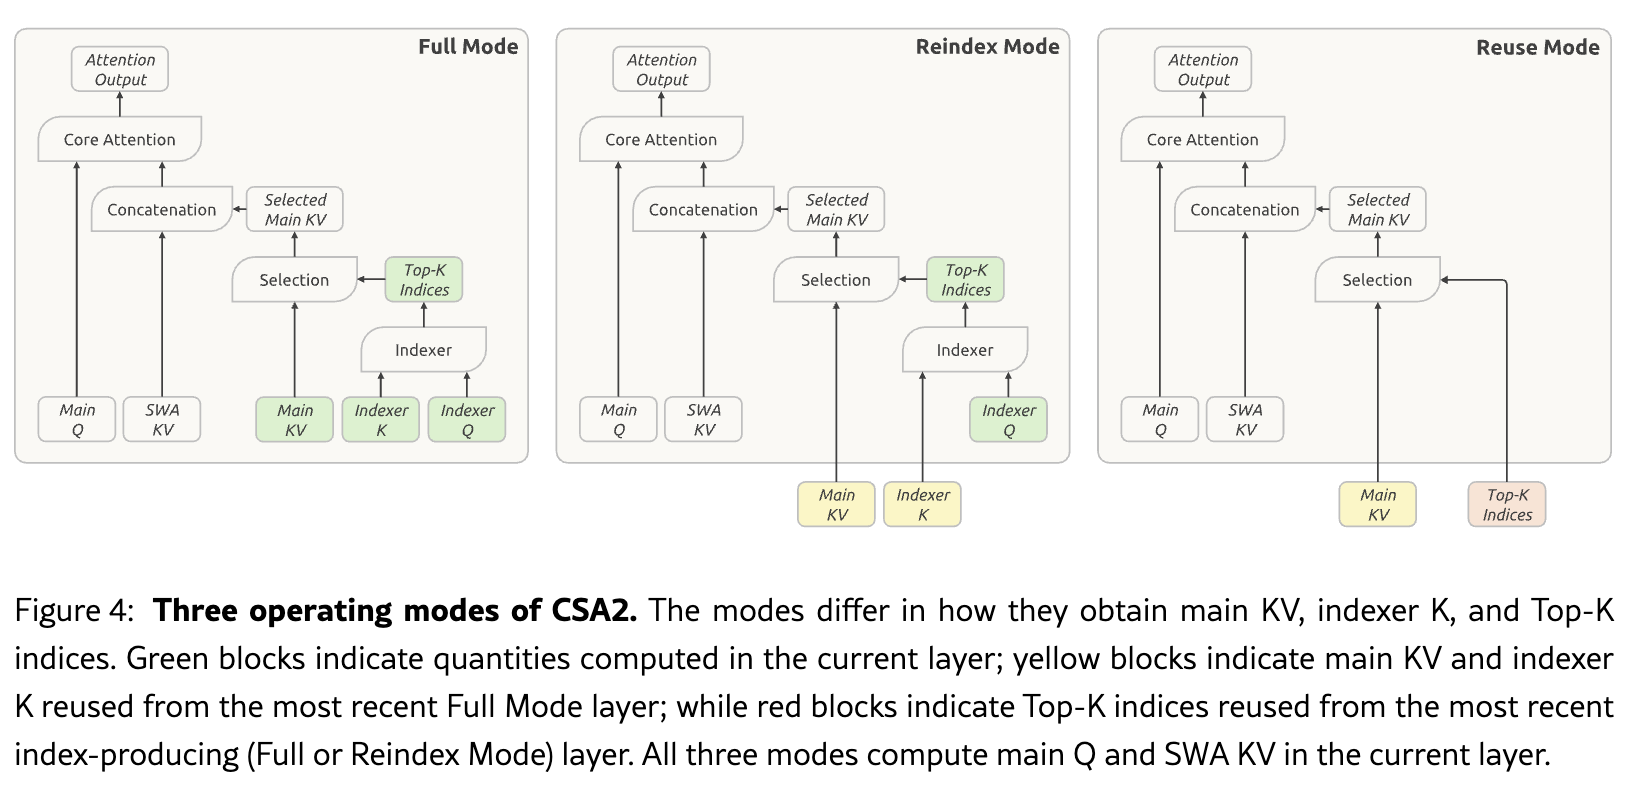
可以把它理解为几个人共用一份资料:有人重新划重点,有人沿用前一个人标记的位置,但每个人仍然根据自己的问题理解这些内容。对应到模型中,三种模式都保留了本层自己的主 Query、局部窗口 KV,以及 Attention 权重计算。因此,共享缓存和索引之后,各层依然能够产生不同的输出。Reuse 省下的是 Indexer 的 Query、打分和 Top-K,并没有跳过主 Attention。
Note | Full Mode 指的是什么
这里的 Full Mode 表示完整执行 CSA2 的计算流程,主 Attention 仍然是稀疏的。共享也发生在同一个 Token 位置的不同层之间;生成下一个 Token 时,会基于新的 Query 重新进行检索。
4.4 分层 Indexer:缩小后续层的搜索范围
跨层复用减少了 Indexer 的推理次数,不过保留下来的 Reindex 层仍然可能面对很长的历史序列。即使只选择 512 个条目,为了找出这 512 个位置,也需要先给候选位置打分。为此,V4.1-Flash 在 Decoder 中引入了 Hierarchical Sparse Indexer,13 让后面的 Reindex 层在前面筛出的候选范围内继续搜索。因为后面讲的 CED 的原因,HSI 这个结构只用在 Encoder 过程中,整体结构如下图所示:
具体过程可以分为两步:
- 第一层做全范围检索。 对全部因果可见位置打分,选出本层 Attention 使用的 Top-512;同时,每 8 个位置组成一个块,以块内最高分作为块分数,选择最多 2048 个块,形成最多 2048×8=16384 个位置的候选池。实现中还会确保最新可见块被保留。
- 后续 Reindex 在候选池中重新打分。 每层使用自己的 Indexer Query,从这些候选位置中选出自己的 Top-512。后面的 Reuse 层则继续复用最新索引。
这里需要分清两个数量:16384 决定后续 Indexer 的搜索范围,512 决定主 Attention 读取多少个全局条目。
第一轮仍然需要扫描完整的可见历史,因此它仍有随上下文长度增长的成本。图中描述的是分层检索算法;要让后续计算量真正随候选池大小变化,需要相应的稀疏 Kernel。官方最小 Python 实现采用了先计算完整分数、再施加候选 Mask 的写法14。
4.5 CED:让 Decoder 的全局 KV 提前生成
除了压缩和共享缓存,V4.1-Flash 还通过 Causal Encoder-Decoder,也就是 CED,减少长输入的 Prefill 计算。这也算是回归初心了,整个结构其实类似于 Transformer 最初的结构。
它将 40 层主干分成前 20 层 Causal Encoder 和后 20 层 Decoder。Decoder 所需的全局 KV 从 Encoder 的最终隐状态 $H_{enc}$ 投影得到。这样,处理历史输入时,完成 Encoder 计算后,就能够准备 Decoder 要读取的全局缓存。
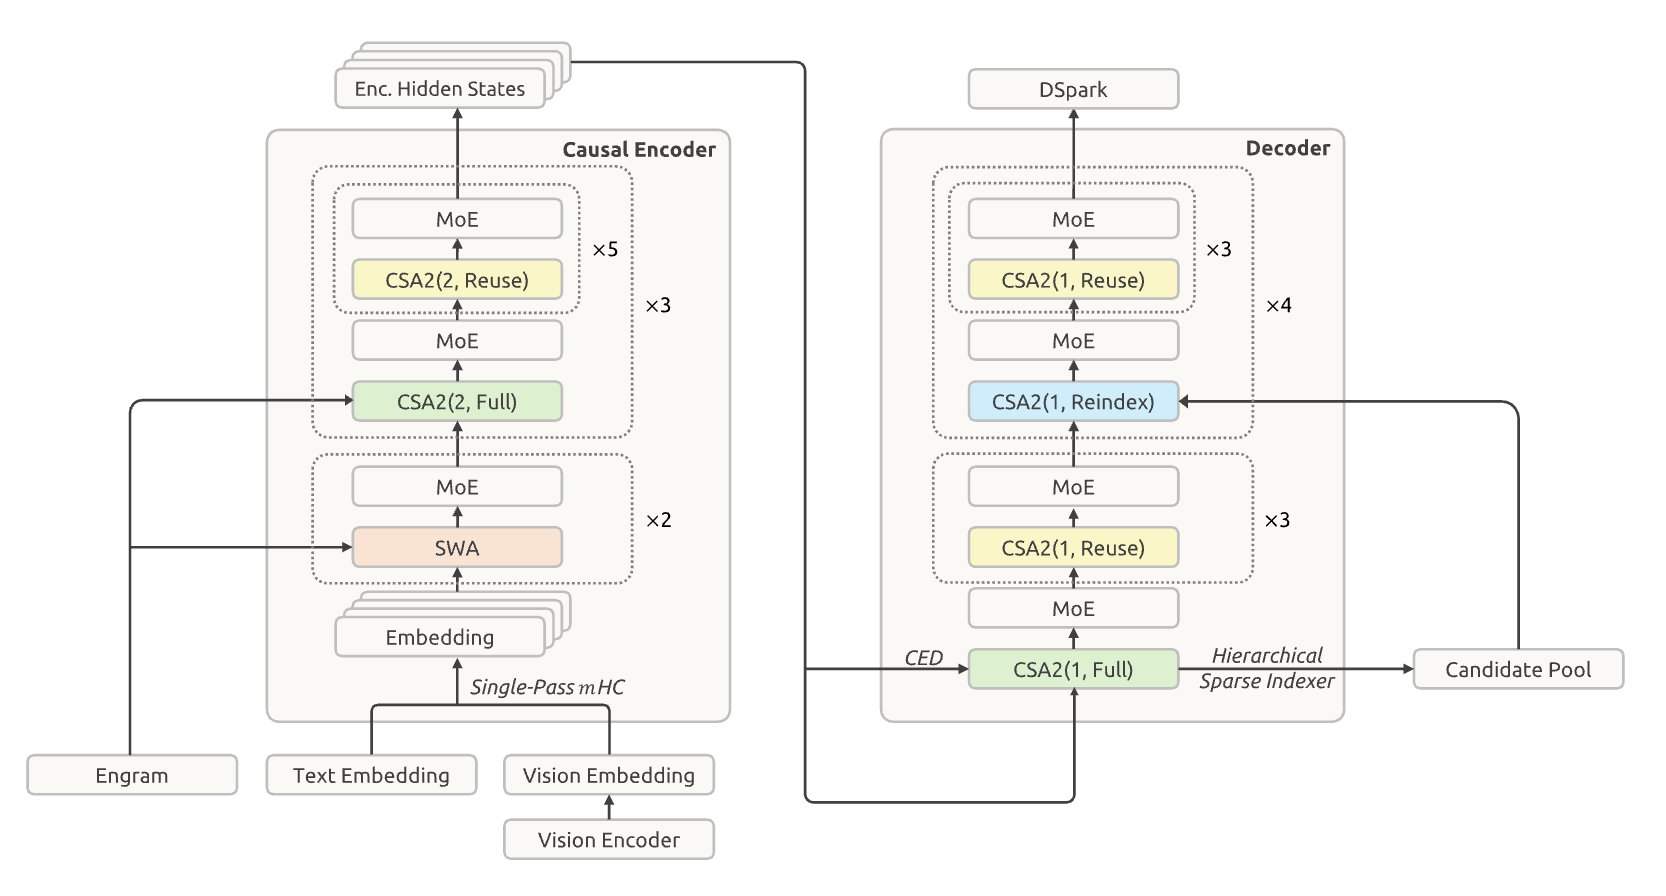
不过,Decoder 的局部窗口 KV 仍然依赖逐层计算。为此,部署时通过 SWA Bounded Replay,补做 Prompt 末尾 128 个 Token 的 Decoder 计算,近似恢复所需的窗口状态。
Important | 与最初的 Transformer 不同
在 CED 中的计算的顺序:Prefill:只计算 Encoder,Decode:计算 Encoder+Decoder。这个地方和最初的 Transformer 不同,最初的 Transformer 是计算 Encoder 后续产生 token 都只需要计算 Decoder 即可。
Insight | CED 省下的是历史输入的 Prefill
因此,对于长 Prompt,大部分位置只需要完成 Encoder 的完整计算,Decoder 主要补做末尾窗口;进入 Decode 后,每个新 Token 仍然经过全部 40 层。这里节省的主要是历史输入的 Prefill 开销。
4.6 CSA2 小结
CSA2 在 CSA 上做了大幅度改进,甚至 DeepSeekV4.1-Flash 已经和 DeepSeekV4 的整体架构有了巨大的不同。总结下来 DeepSeekV4.1-Flash + CSA2 主要在这个方面有了升级:
- 简化 Compressor,共用压缩结果:改进了 Compressor,不再做 Overlap 和 APE,同时使用一个 KVCompressor 可以产生 Indexer 和 KV 两个地方的后续 feature。
- 做了三个层次的共享:最大程度的降低 Indexer 计算的带来的开销。
- Hierarchical Sparse Indexer:Decoder 的第一个 Full 层扫描可见历史,除了选出本层的 Top-K,还通过块级筛选建立一个更大的候选池。后续 Reindex 层在这个候选池中选择自己的 Top-K,从而减少重复的全范围检索。候选池可以共享,但各层最终关注的位置仍然可以不同。
- 引入 CED,降低长输入的 Prefill 成本:Decoder 的全局 KV 直接从 Encoder 最终输出生成,因此大部分 Prompt Token 只需完成 Encoder 计算,再补做末尾窗口的 Decoder 计算。Decode 阶段,每个新 Token 仍然经过完整的 Encoder 和 Decoder。
- 引入 FP4 KV15:这块主要是工程上的优化,全局主 KV 使用 FP4,Indexer K 使用 MXFP4,再配合跨层共享,将全模型的全局缓存占用降低到约 890 bytes/token,约为 V4-Flash 的四分之一。
5. 总结
从 MLA 到 DSA 再到 CSA 和 CSA2,DeepSeek 一直在追求算法与工程的的 tradeoff。在满足算法的要求的基础上,已经将 KVCache 的内存与内存带宽需求,Prefill/Decode 的算力需求做了大幅度降低。甚至在 DeepSeekV4.1-Flash 上做了 CED 这种架构上的机制极大调整,只能说整个算法团队和工程团队实在是太有实力和魄力了。笔者也非常喜欢使用 DeepSeekV4.1-Flash,在 DeepSeek 的工程优化下基本上可以长期跑满 200-400TPS 的速度,虽然 DeepSeekV4.1-Flash 的 RL 还需要持续调整和改进,但是其牛逼的工程能力确实可以将 Agent 的体验得到了极致。
因为 DSA 的 Indexer 只需要生成适合 Top-k 选择的分数,而 ReLU+按头加权是一种计算便宜的多头打分方式。 论文提到:选择 ReLU 是出于吞吐考虑 ↩︎
训练 Indexer 时,其实仍然使用 Softmax: 论文对最终的 $I$ 做 Softmax,再用 KL 散度对齐主注意力分布,让 Indexer 学会哪些 token 值得保留。推理时只取 Top-k;选完之后,主 MLA 再计算自己的注意力分数和 Softmax 权重。 ↩︎
Temporal Correlation Meets Sparse Attention: Guess-Verify-Refine Top-K for Blackwell ↩︎
DeepSeek:DeepSelect DeepSeek 伴随 DeepSeekV4.1-Flash 开源的 kernel ↩︎
FlashMLA Blog: A Deep Dive Into The Flash MLA FP8 Decoding Kernel on Hopper: With a smaller topk, the relative overhead of the kernel’s prologue and epilogue becomes larger compared with dense decoding with long context length. If we set topk to a larger value, such as 32768, this kernel can achieve up to 460 TFLOPS ↩︎
短上下文情况下跳过 Indexer 的实现 vLLM(对应的参数为
enable_short_prefill_scoring_skip)SGLANG(对应的环境变量为SGLANG_DSA_PREFILL_DENSE_ATTN_KV_LEN_THRESHOLD) ↩︎MiniMax Sparse Attention:https://arxiv.org/pdf/2606.13392 ↩︎
IndexCache: https://github.com/THUDM/IndexCache ↩︎
Heterogeneous KV Entries in DeepSeek-V4: https://arxiv.org/html/2606.19348#S3.SS5.SSS1 ↩︎
官方使用 Pytorch 实现的一个简单 Hierarchical Sparse Indexer https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/inference/model.py#L583 ↩︎
DeepSeekV4.1-Flash Paper section 6: In this work, we introduce DeepSeek-V4.1-Flash, a multimodal Mixture-of-Experts (MoE) model with support for contexts of up to one million tokens. Through joint optimization of model architecture, cache precision, and deployment strategy, DeepSeek-V4.1-Flash pushes the limits of KV cache compression. Its Causal Encoder-Decoder (CED) architecture enables the model to activate only 8B parameters per token during prefill, compared with 16B during decode, improving cost efficiency for input-heavy agentic workloads. At equal sequence lengths, cross-layer KV cache reuse in Compressed Sparse Attention 2 (CSA2) and FP4 KV caching reduce its global KV cache footprint (always in HBM) to 890 bytes per token, roughly 1/4 of the corresponding footprint of DeepSeek-V4-Flash. SWA Bounded Replay further reduces its persistent KV cache footprint (always on SSD or in host memory) to roughly 1/8 of that of DeepSeek-V4-Flash. These reductions alleviate HBM and SSD capacity pressure while the model delivers substantially better overall performance than DeepSeek-V4-Flash. Despite possessing a significantly smaller parameter footprint than contemporary open-source models such as GLM-5.3 and Kimi-K3, DeepSeek-V4.1 achieves comparable—and in several tasks, superior—performance across key benchmarks. ↩︎