DeepSeek 的 Attention演进 -【MLA】
前言:读完 DeepSeekV4.1 论文,看到 DeepSeek 又一次对模型结构做了大改,笔者颇为激动。于是回顾了一下 DeepSeek 对模型结构的逐步改进,在等 Agent 跑完、工作摸鱼的间隙写下了这系列文章,也算是转到 AI Infra 一年来,对模型结构学习的一个总结。
本文主要介绍 DeepSeek 模型演进中的Attention结构的变化,也展示了从 KVCache 优化角度 DeepSeek 的结构是如何逐步演进的,尤其是结构上对算法和工程的 tradeoff 做一个比较详细的介绍。DeepSeek 的 Attention 选择与设计确实非常优秀,从工程到算法角度都有非常独到的地方,以至于后续国产的大模型 GLM5.x/Minimax3.x/Kimi2.x系列都沿用了 DeepSeek 的设计,或者在其基础上进行一些改进。
1. MHA 用于序列建模,Transformer 的诞生
1.1 背景与问题
这是一个很经典的问题,MultiHead Self-Attention 结构伴随着Transformer诞生,其主要是为了取代 RNN/LSTM(Recurrent Neural Network) 序列建模中两个问题。
- 长距离依赖建模问题(核心问题):RNN/LSTM 一直使用一个固定状态 $S$来压缩过去所有状态信息,因此如果输入序列比较长的时候,过量的压缩会导致丢失长距离信息。
- 并行问题(计算效率问题):RNN/LSTM 只能串行计算,如下图所示 RNN 计算状态的时候必须是串行的,只有 $S_{t-1}$计算完成的之后。Attention 是可以并行计算的,一个矩阵/张量就可以一次性算完所有位置。
下图1就可以直接看出这两个问题所在
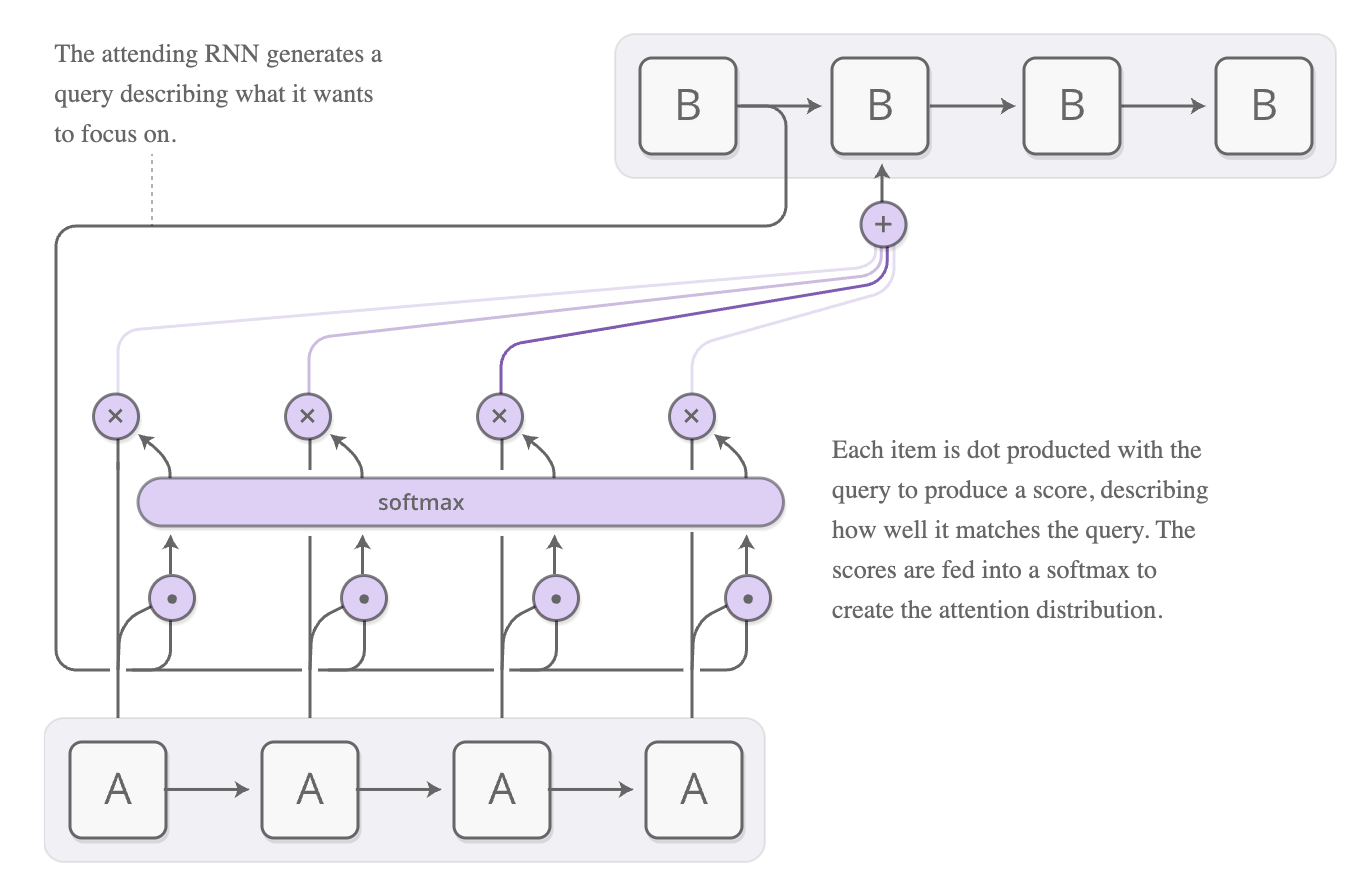
RNN 计算下一个 Token 的时候对之前序列的计算是串行的,先算完前一个信息,同时存储状态再计算下一个信息。
1.2 Attention的引入 - 序列的 token2token 建模
为了解决这两个问题 Transformers 在设计之初引入 Attention 对序列进行建模,他的结构如图1所示:直接对整个序列进行 Pair2Pair 的计算,因此解决之前的两个问题。但实际上会更加抽象一些,将序列 Pair 问题转为一个查表问题
- 将输入 $X$ 映射为 $K$, $V$两个向量,其中如同计算机一样 KV 是一个pair 对
- $X$ 映射为一个 $Q$, 这个 $Q$ 就是我们常说的查询向量
- 通过 $score=softmax(QK^T)$计算相关性的方式计算出 $X$ 各个 Token 之间的关系,
- 最后与 $V$ 向量相乘做一个加权 sum, $O=score \cdot V$。当然 Transformers 也做了一些细节处理,比如说为了处理 $QK^T$随着维度 $d$ 会膨胀从而导致 $softmax$进入饱和梯度区,因此做了一个简单的Scaled Dot-Product Attention(缩放点积注意力) 其分数改为 $score=softmax(\frac{QK^T}{\sqrt{d}})$。
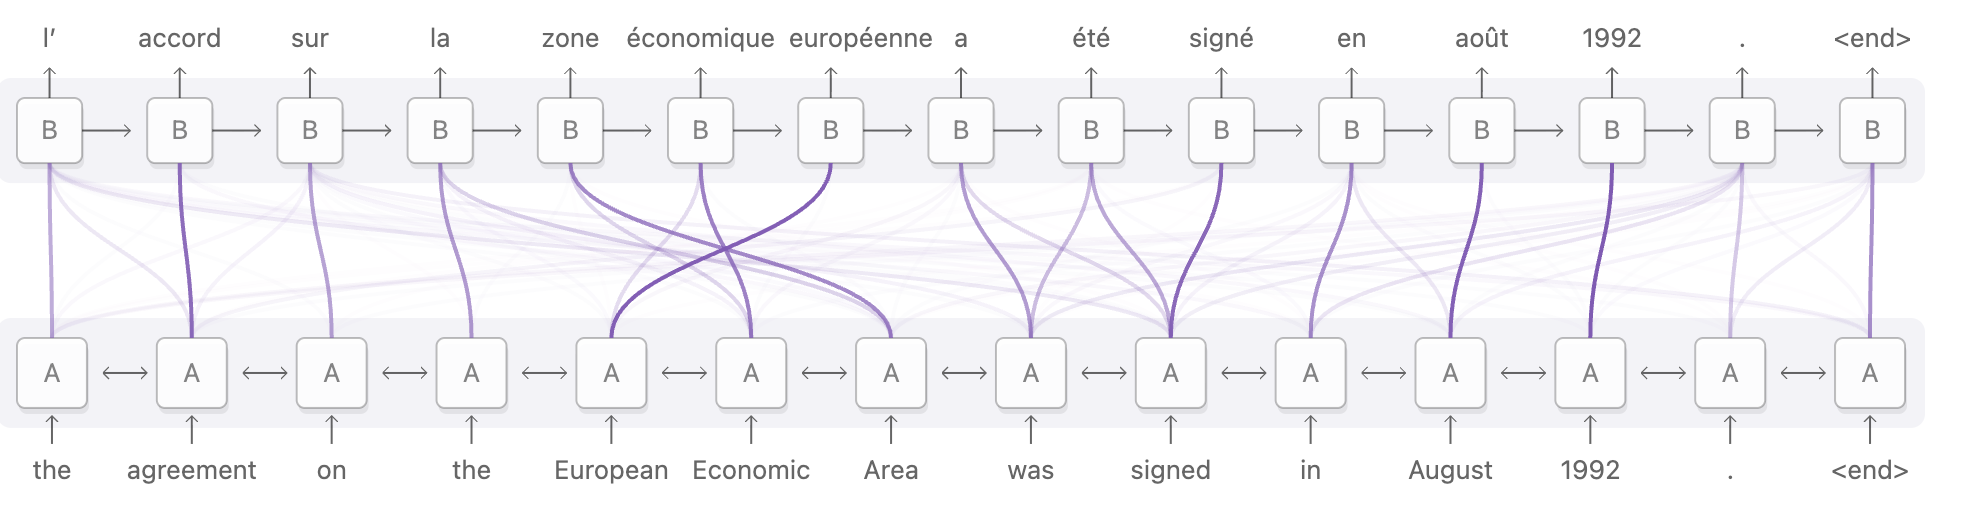
然后看这两个问题的解决:
- 为什么可以解决长程依赖问题: Attention 是直接对任意两个位置的 Token 的关系进行计算的,因此不存在状态一直累计和重叠的问题。
- 为什么能解决计算效率的问题:如 1 一样,因为可以抽象为一个 $O=score \cdot V$ 直接就是两个矩阵的乘法,因此GPU可以很高效的计算。
1.3 MultiHead:多维信息映射
同时为了增加对多维信息的表示,Transformers 引入的 MultiHead 的结构,也就是说在计算的时候首先先讲输入 $X$ 映射为多个Head,这是为了增加多种信息的聚合。 原文中介绍为2:
Multi-head attention allows the model to jointly attend to information from different representation subspaces at different positions.
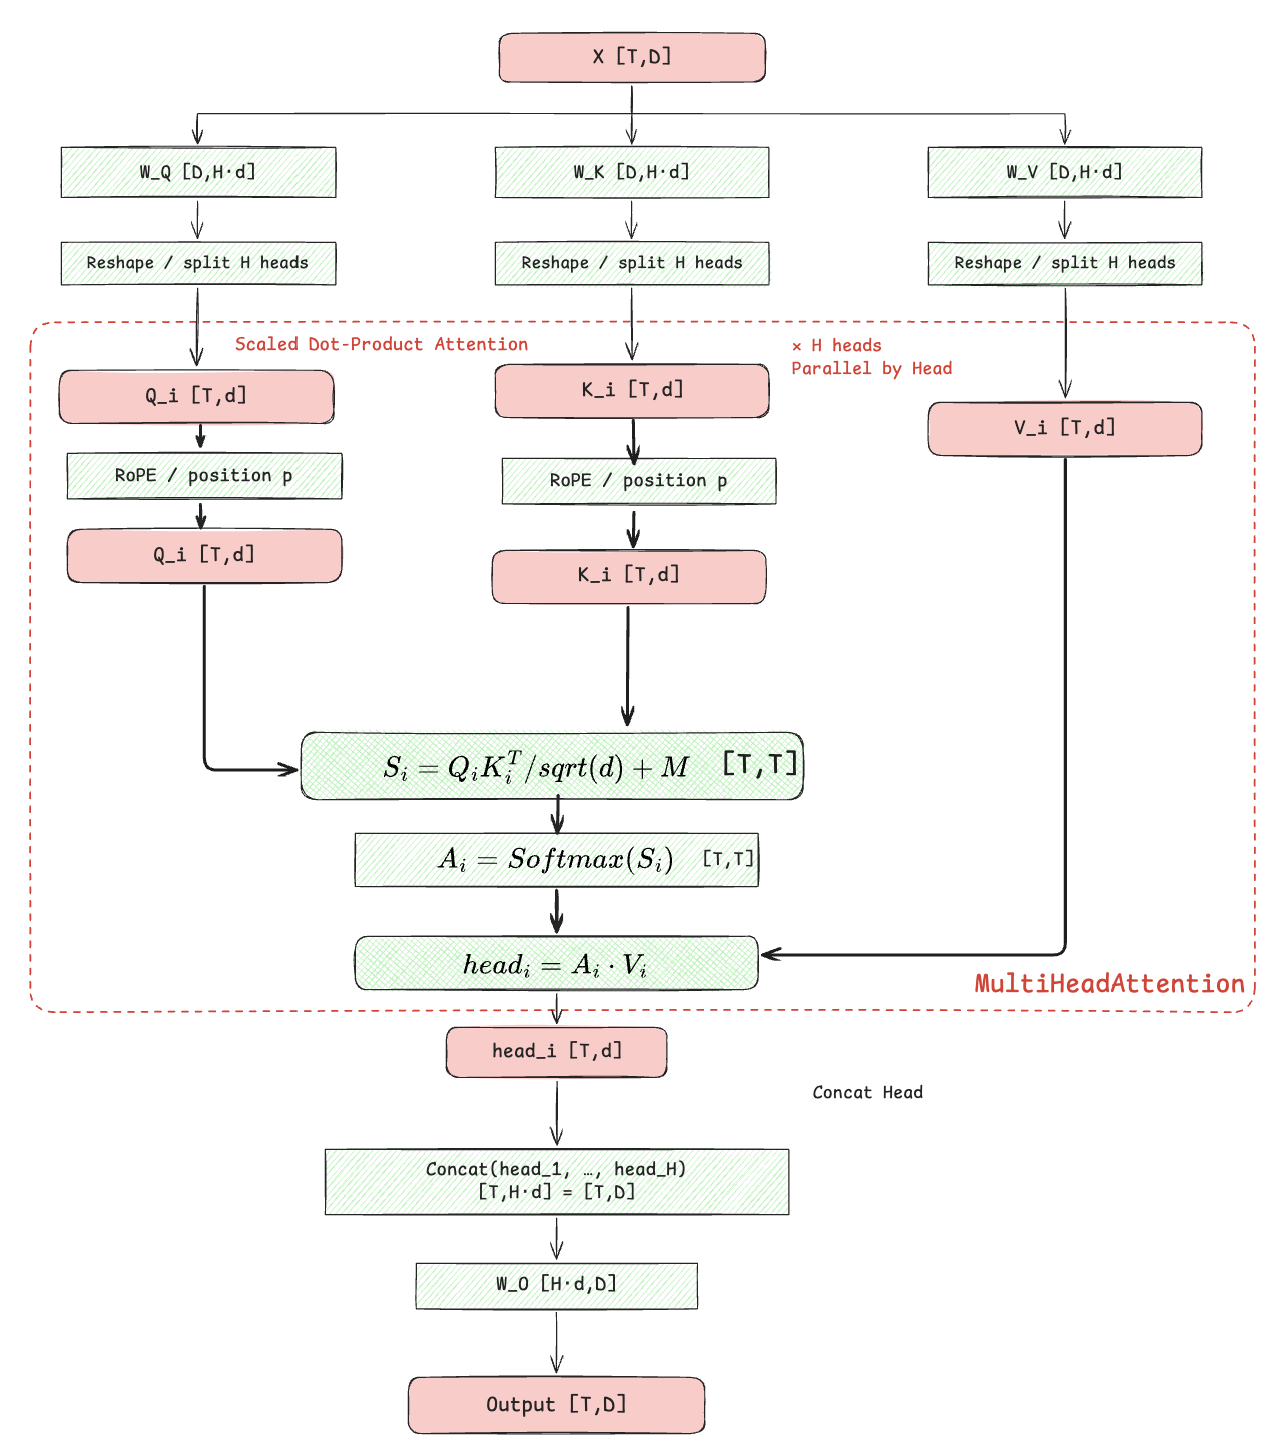
因此最终的 MHA 就变成了这个结构:
$$\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)\\, W^O$$其中每一个头:
$$\text{head}_i = \text{Attention}(Q W_i^Q,\ K W_i^K,\ V W_i^V)$$每个头的Attention 为:
$$\text{Attention}(Q,K,V) = \text{softmax}\\!\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$整体的结构为下图
1.4 MHA 的问题:计算与存储的膨胀
那么说了怎么多MHA 的好处,那么这样建模的代价是什么呢?
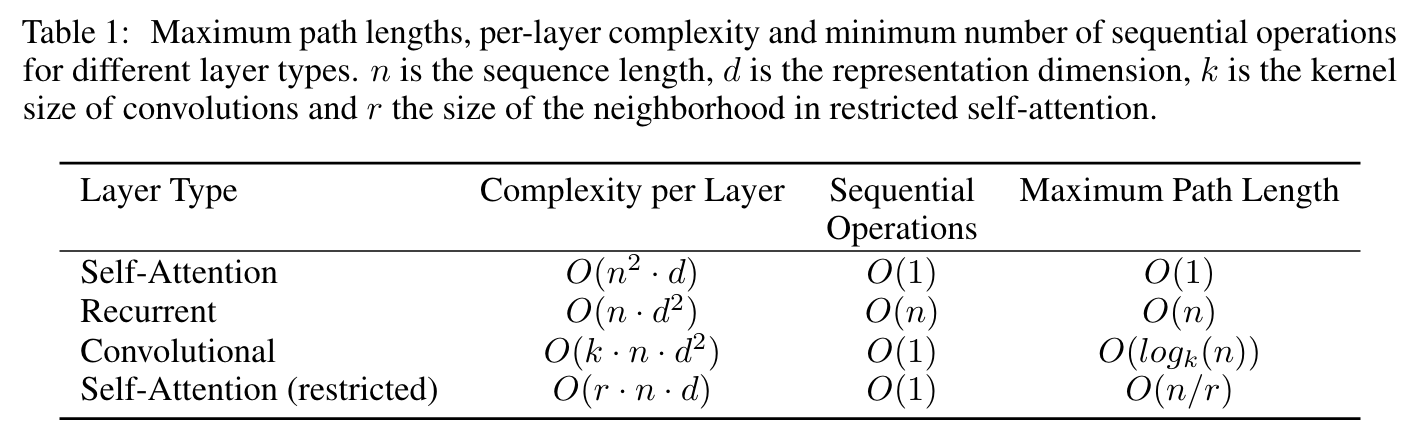
Transformers 论文中有一个表格展示这个代价,因为 Pair2Pair 建模,计算复杂度都变成了 $O(N^2)$, 中间的 KV 存储随序列膨胀速度为序列长度 N 的线性正比,对比起来 RNN 的时间复杂度是 $O(N)$,空间复杂度是$O(1)$。因此因为大模型出现,长序列问题出现之后大家又来说衍生出了 LinearAttention(可以认为是 RNN 的变种)/SWA 用来降低在长序列下的 Attention 的计算复杂度和 KVCache 所占的空间。
1.5 GQA/MQA - KV 的复用
不这里我们先不谈 SWA 和 LinearAttention 这两种现在用的比较多的结构,先看最经常说的 MHA/GQA/MQA 的变化与演进
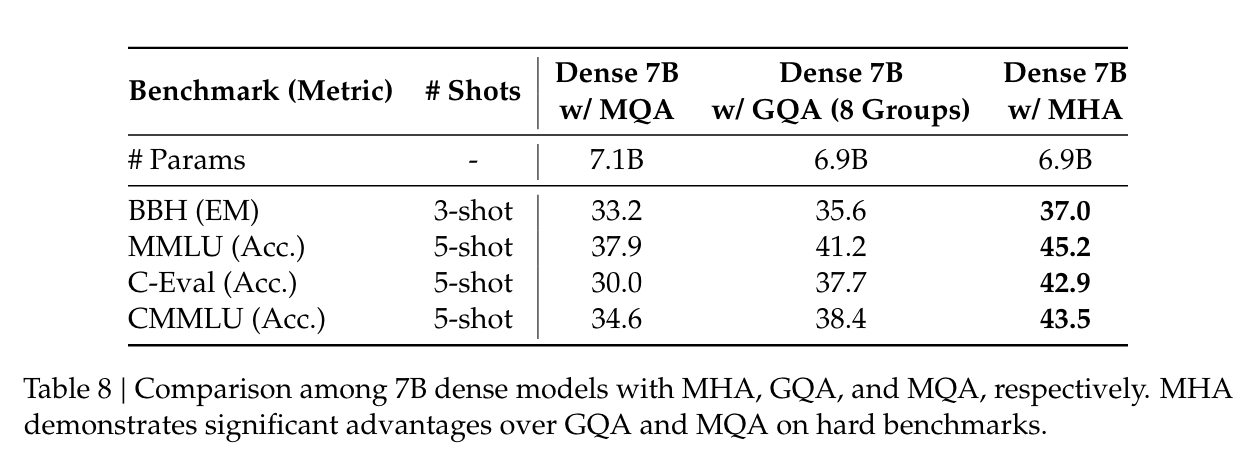
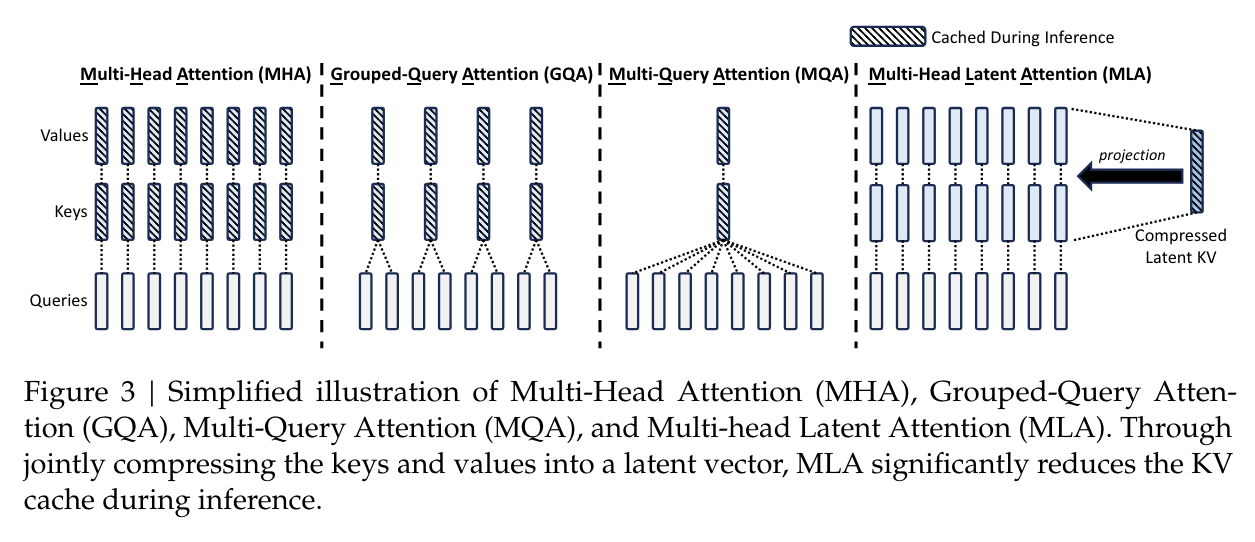
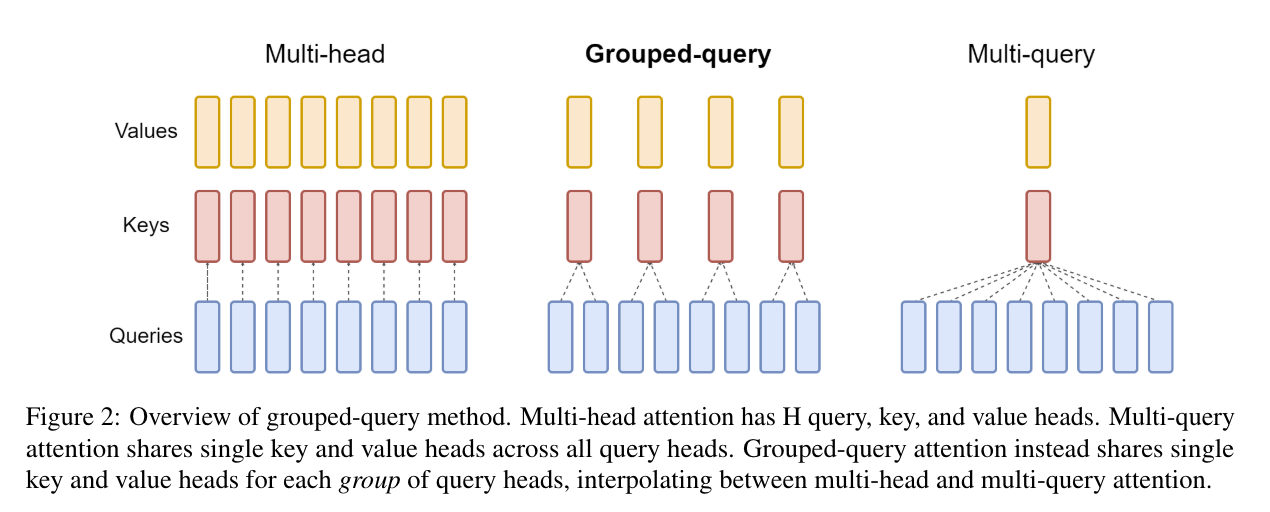 这里又可以搬运出大家非常非常经常看到的一张图,来源3。这两种方式都是通过多个 Head 共享 KV 的方式降低计算量和 KVCache 的存储空间,GQA 是 G 个头共用一组 KV,MQA 是所有头共有所有KV,但是对比起来还是 MHA 效果好。比如说早期的 Qwen2/Llama/GPT-OSS系列就是用 GQA。
2. 将KV压缩进Latent中 - 从MHA 到 MLA
2.1 问题与背景
又又又老生常谈的问题,从 LLM 推理工程角度来看,对于 Decode-Only 结构的 LLM 来说,可以将推理过程分为 Prefill和 Decode。Prefill 侧重计算前序序列的 KVCache 和第一个 Token,Decode用来迭代计算后续的 Token。Prefill 是 Compute-Bound 而 Decode 是 Memory-Bound。因为在整体的工程角度 Memory-Bound是更难解决的一个问题,因此 MLA 的出现是着重解决推理过程中 KVCache 的 Memory-Bound 的问题。
2.2 Lora:降维与升维
如何解决? 其实的思路也很简单,是使用在 DL 中经常使用的 Lora 作一个降维,然后计算 Attention,然后计算完成之后再通过一个矩阵映射到高维进行输出。这个技巧广泛使用在 DeepLearning 的各种神经网络结构中,最近的 Latent-MoE 也是这个思路,只不过将 MHA 变为了 MoE,通过降维的方式去降低 MoE 的通信量。
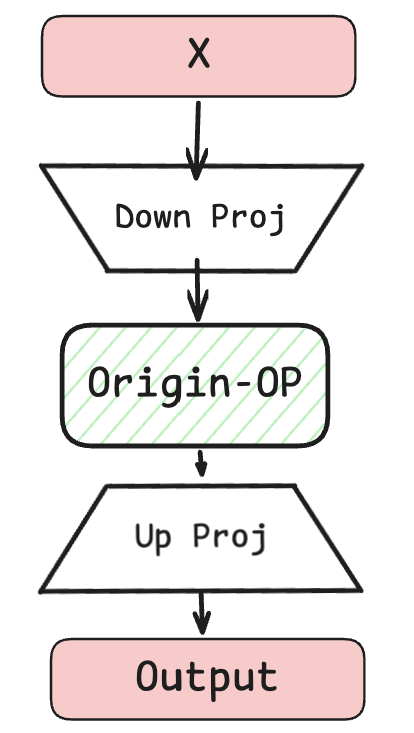
什么是 Lora:它利用高维数据矩阵内部存在大量冗余、有效信息只集中在少数几个主方向上的特点,把原本 $d \times k$ 的数据用一个远小于它的秩 $r$ 来表示(先压缩到 $r$ 维瓶颈、再升维还原),使数据量从 $d\times k$ 降到 $r\times(d+k)$,从而在信息损失可控的前提下大幅降低计算量和显存(如压缩 KV cache)。简而言之就是使用一个信息密度更高的低维度的向量表示一个高维的向量,从而降低存储/计算的复杂。
MLA在这个思路上对 MHA 有进行一部分改造,核心的操作主要是降低计算时候 KVCache 的量所以我们可以看到 MLA 计算 Q/K 都是直接将做了一个降维的矩阵乘,将之前的维度降低为一个低秩表达 $C$。那对于这一点,结构可以通过之前 MHA 改为有 Lora 的 MHA,如图所示: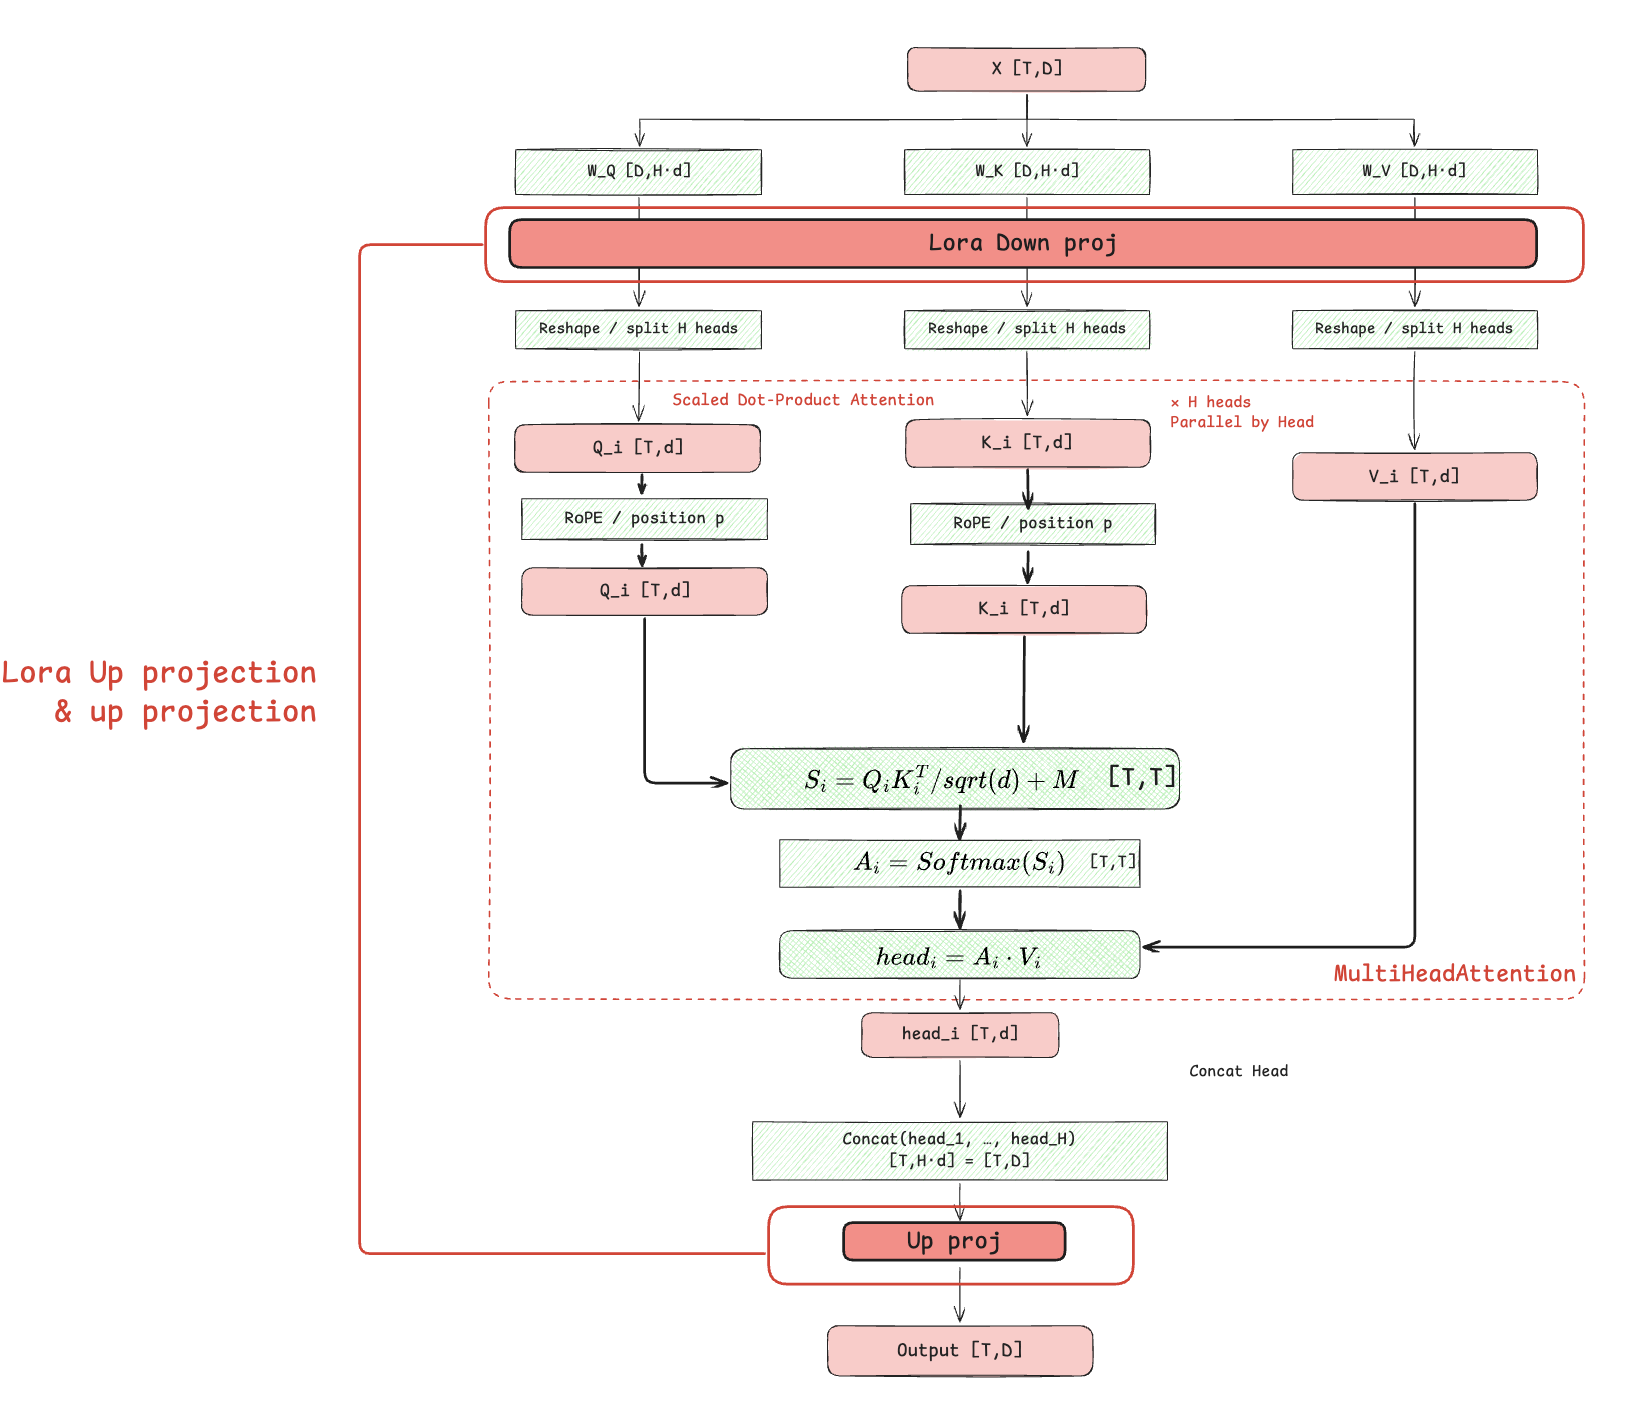
但是为了推理性能引入了一个小的结构上的改动,就是将 RoPE 从K运算的主干拆分出去,单独出一个分支去计算 $K$ 的RoPE。为什么会这样?解释原理之前我先介绍一下推理中常用的一个 trick,就是矩阵吸收,也是很简单的数学技巧。
2.3 矩阵吸收
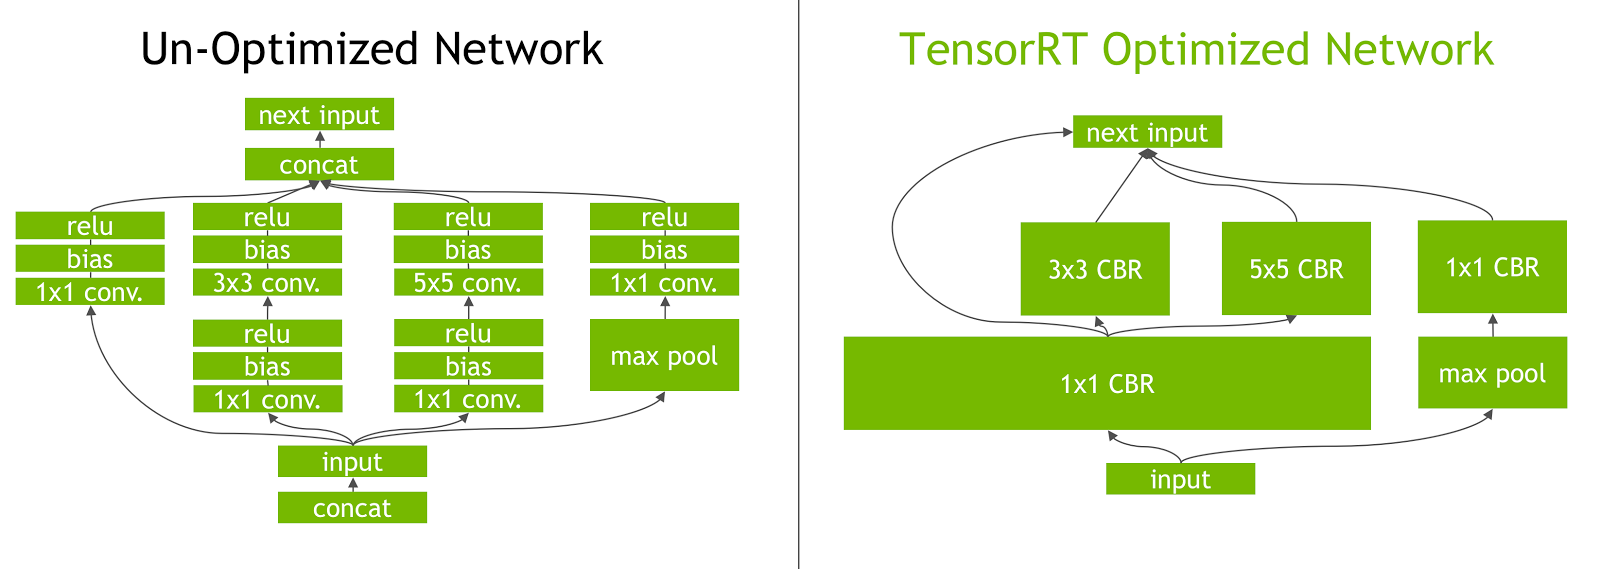
在模型推理中,许多结构可以通过数学的方式合并在一起,比如说在 CNN 时代 TensorRT经常会做这种优化,如下图4所示,会将多个操作合并为一个操作。这个行为在 LLM 时代的推理优化也经常使用,比如说上图我们在计算 QKV 的时候,其实可以把 $Q=W_qX$, $K=W_kX$ , $V=W_vX$ 中的三个映射矩阵合并为一个 $[Q,K,V] = [W_q, W_k, W_v]X$ 这样我们就可以使用一个 Kernel 同时计算三个输出结果,大大简化了 Kernel 的 Launch 以及准备工作。
在进一步,一些操作比如说要同时过两个映射,比如说
$$O = W_b(W_aX)$$我们也可以通过矩阵的结合律变换为
$$O = (W_bW_a)X = W_{fuse}X$$在模型 load 的时候就提前把 $W_{fuse}$,这样在推理的时候就不用做多次运算操作。这种操作有个专门的名词:矩阵吸收(Matrix Absorption) 他的好处是显而易见的,可以加速推理。但是也有一个坏处,就是会损失精度5。
2.4 RoPE分支:位置编码的问题与解决
回到 MLA 中,在DeepSeek 的论文中作者也希望通过Matrix Absorption的方式去优化 MLA 的推理,即使精度略有下降,但是可以换取整个推理速度的提升。这个时候就会发现 RoPE 成为了拦路虎。直接用低秩压缩会踩一个坑:旋转位置编码(RoPE)是位置敏感的。
- 如果对压缩还原出来的 $k^C$ 施加 RoPE,那么 $W^{UK}$ 会和"与当前 token 位置相关的 RoPE 矩阵"耦合在一起;
- 因为矩阵乘法不满足结合律,$W^{UK}$ 就无法被吸收进 $W^Q$,推理时就得为所有前缀 token 重新算 K → 缓存白压了。代数上仍然可以合并,但失去了 MLA 所需要的“只变换当前 Q 一次,就能复用到所有历史位置”的优化
我们把当前的 $q$ 视为已经完成自身的 RoPE,只看历史 K 这一侧。
没有 RoPE 时,所有历史 Key 都用同一个矩阵 $U$:
$$k_1=Uc_1,\qquad k_2=Uc_2,\qquad k_3=Uc_3$$所以只需算一个 $\widetilde q=U^\top q$,就能拿它与 $c_1,c_2,c_3$ 分别点积。
有 RoPE 时,每个位置多了一个不同的旋转矩阵:
$$k_1=R_1Uc_1,\qquad k_2=R_2Uc_2,\qquad k_3=R_3Uc_3$$把这些变换移到 Q 一侧,就变成:
| 与哪个历史位置比较 | 需要的变换后 Query |
|---|---|
| 位置 1 | $\widetilde q_1=U^\top R_1^\top q$ |
| 位置 2 | $\widetilde q_2=U^\top R_2^\top q$ |
| 位置 3 | $\widetilde q_3=U^\top R_3^\top q$ |
现在需要三个不同的 $\widetilde q$。历史有一万个位置,就可能需要一万个。
即使提前把 $R_jU$ 合并成矩阵 $M_j$,也仍然是每个位置一个不同的 $M_j$,需要分别作用到当前 Query 上。
那如何解决这个问题呢?再专门开一个分支去算 RoPE,同时可以将之前 $X+RoPE$ 的方式转化为 $[X;RoPE]$ 的方式,这样没有 RoPE 的地方可以接着维持很好的矩阵吸收 trick。那 K 这么变化了 Q 也需要同样的变化。因此 MLA 就变成了这个结构:
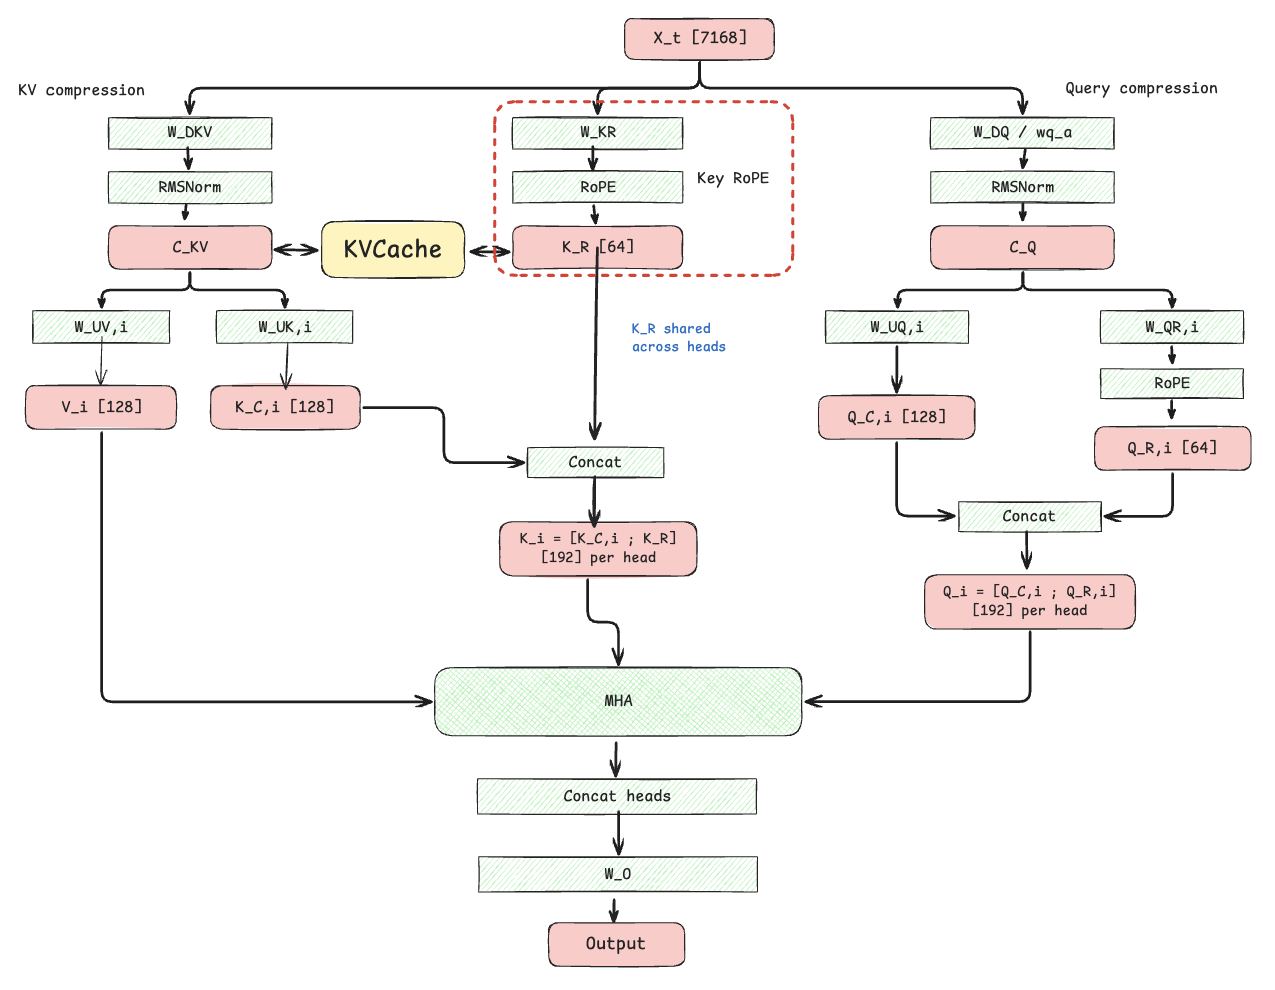
一个工程和算法上都做了兼容的结构。DeepSeekV2的论文也做了消融实验:MLA 在效果上是完全好于 MQA 和 GQA 的。
 总结一下他和 MQA 和 CQA 的区别,DeepSeekV2 论文一图胜过千言
2.5 MQA/MHA 双形态
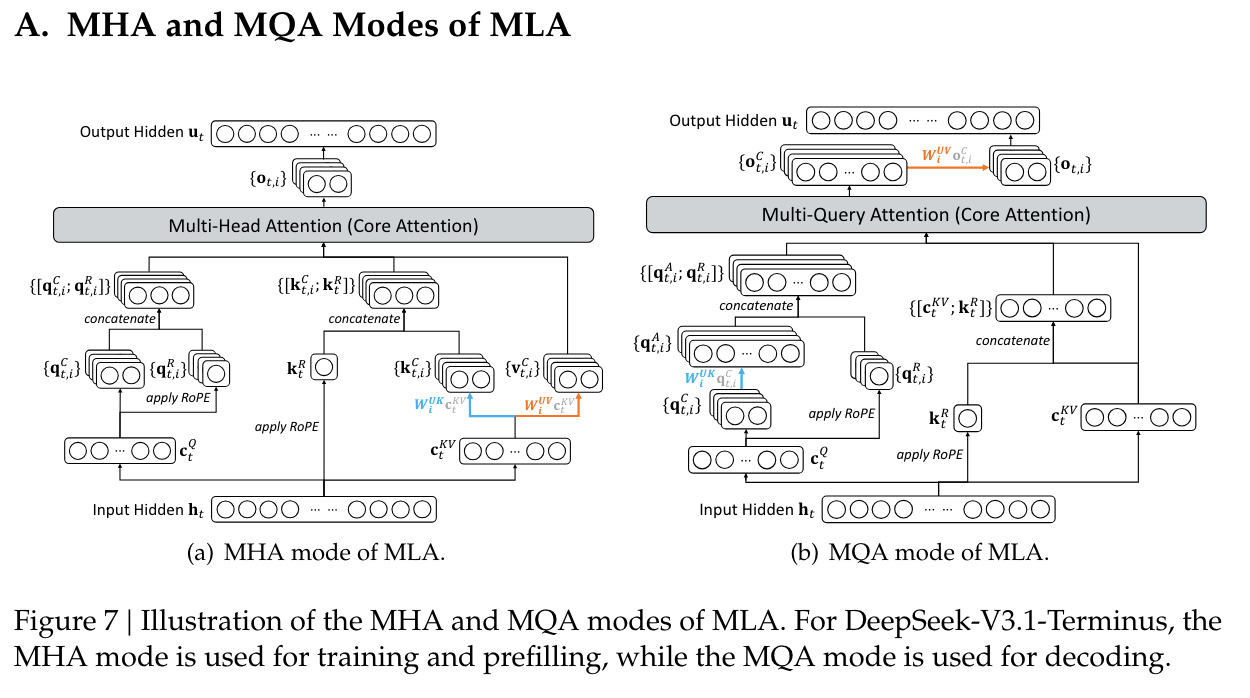
接着矩阵吸收,是不是可以进一步优化推理呢,这个时候其实可以通过进一步的Absorption将后续所有参数都合并呢?答案是可以的,甚至可以将MLA完全转化为 MQA 的形态。在 DeepSeekV3.2的论文附录里面也提到了这个优化:
如何实现呢?其实基于很简单的多个数学上的合并运算,这里我直接总结苏神的推导6 感兴趣的可以直接看苏神的推导:
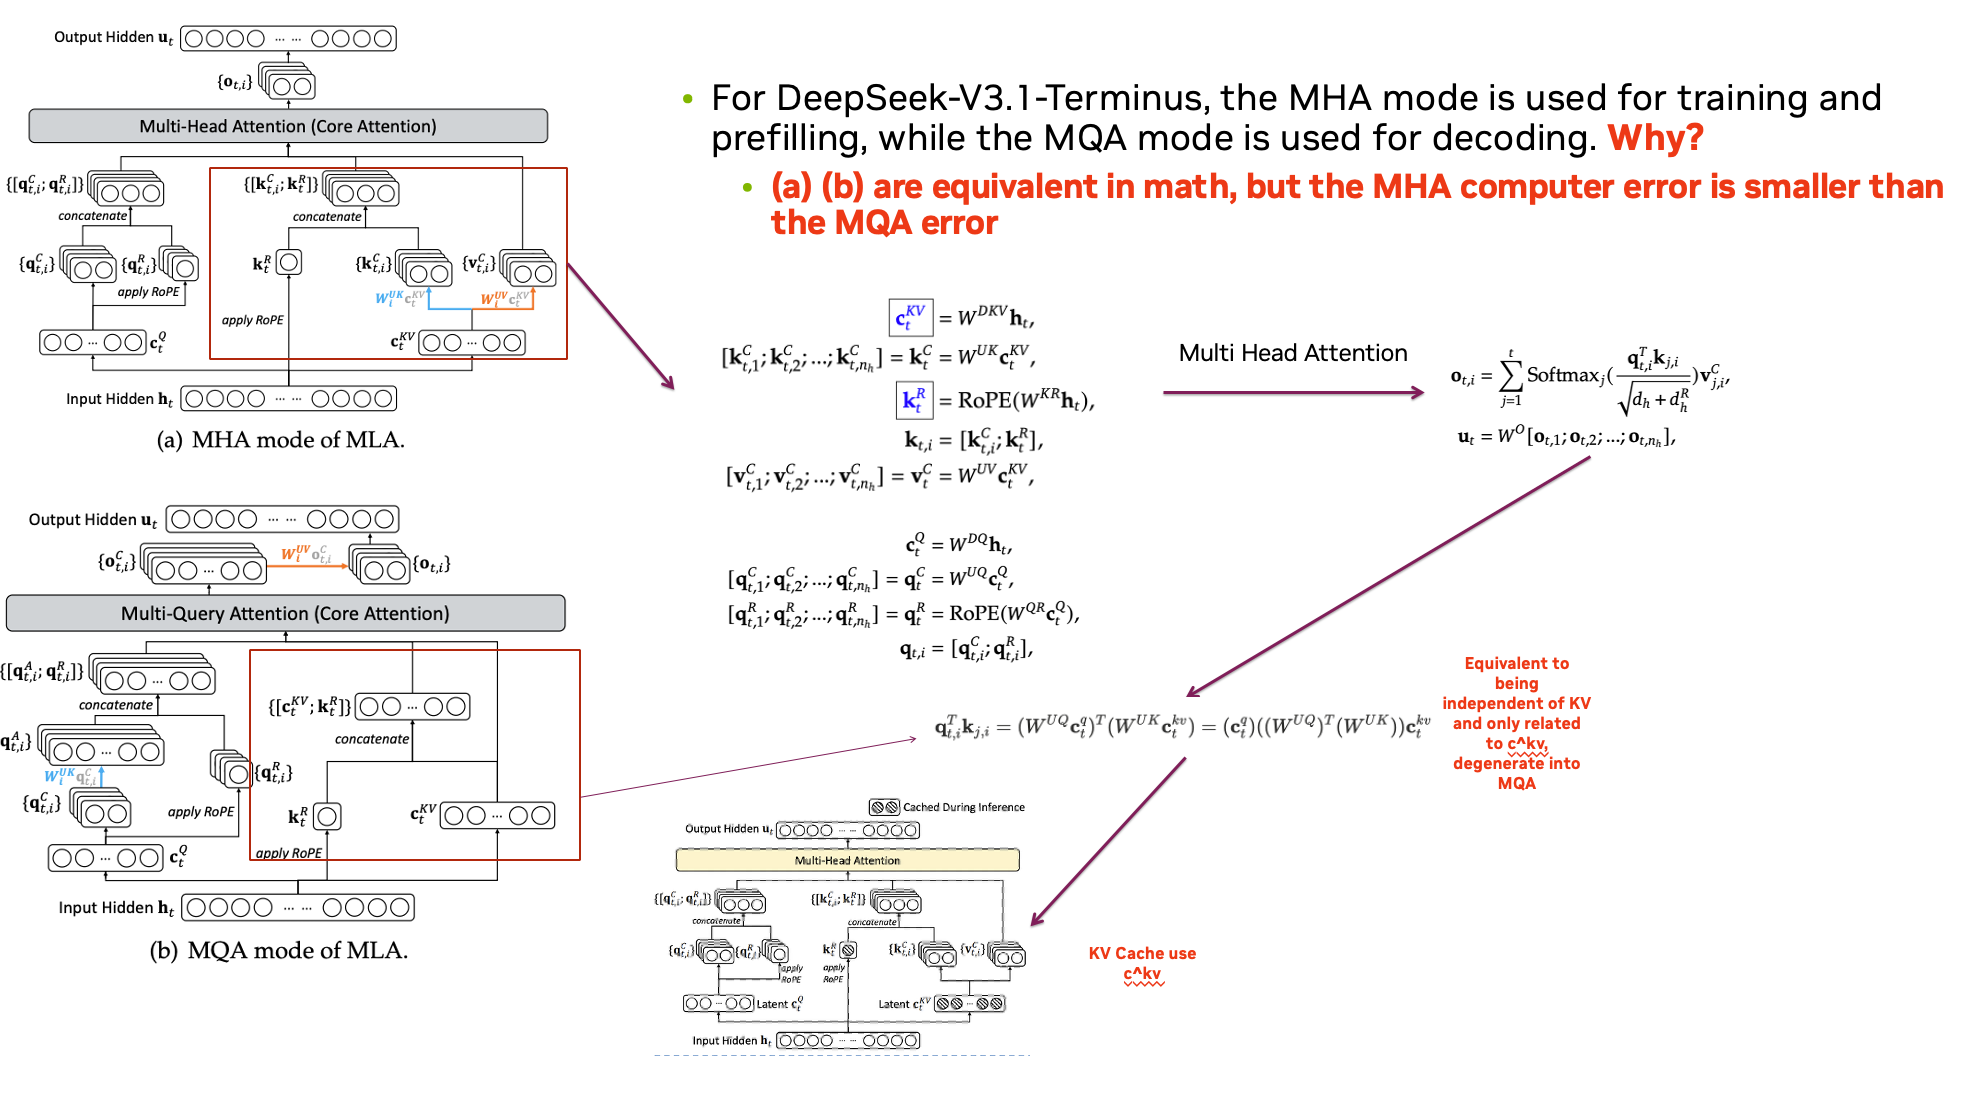
核心就一个公式:
$$ \mathbf{q}_{t,i}^{T}\mathbf{k}_{j,i} = \left(\mathbf{W}^{\mathrm{UQ}}\mathbf{c}_{t}^{\mathrm{q}}\right)^{T}\left(\mathbf{W}^{\mathrm{UK}}\mathbf{c}_{t}^{\mathrm{kv}}\right) = \left(\mathbf{c}_{t}^{\mathrm{q}}\right)\left(\left(\mathbf{W}^{\mathrm{UQ}}\right)^{T}\left(\mathbf{W}^{\mathrm{UK}}\right)\right)\mathbf{c}_{t}^{\mathrm{kv}} $$从这个角度,我们可以绕开Latent $C$ reshape 成MultiHead 的格式,单个 $Q$ 对应单个 $V$的方式一步计算出整个相关系数Score。从形式上完全可以看成是一个MQA的样式。这种结构把很多计算都在推理前都预计算好了,同时也将一个 MHA 变为 MQA 效率也更高。MLA 的 MHA 形态与 MQA 形态在数学上等价,但计算量与访存特征不同,因此适合不同的推理阶段。
- Prefill 阶段通常采用 MHA 形态。 此时需要同时处理大量 Query,可以先将共享 latent 展开为各头的 K/V,并让多个 Query 复用这些结果。展开后的每头维度通常小于 latent 维度,因此核心注意力计算需要的 FLOPs 更少,也便于使用成熟的高效 MHA kernel。
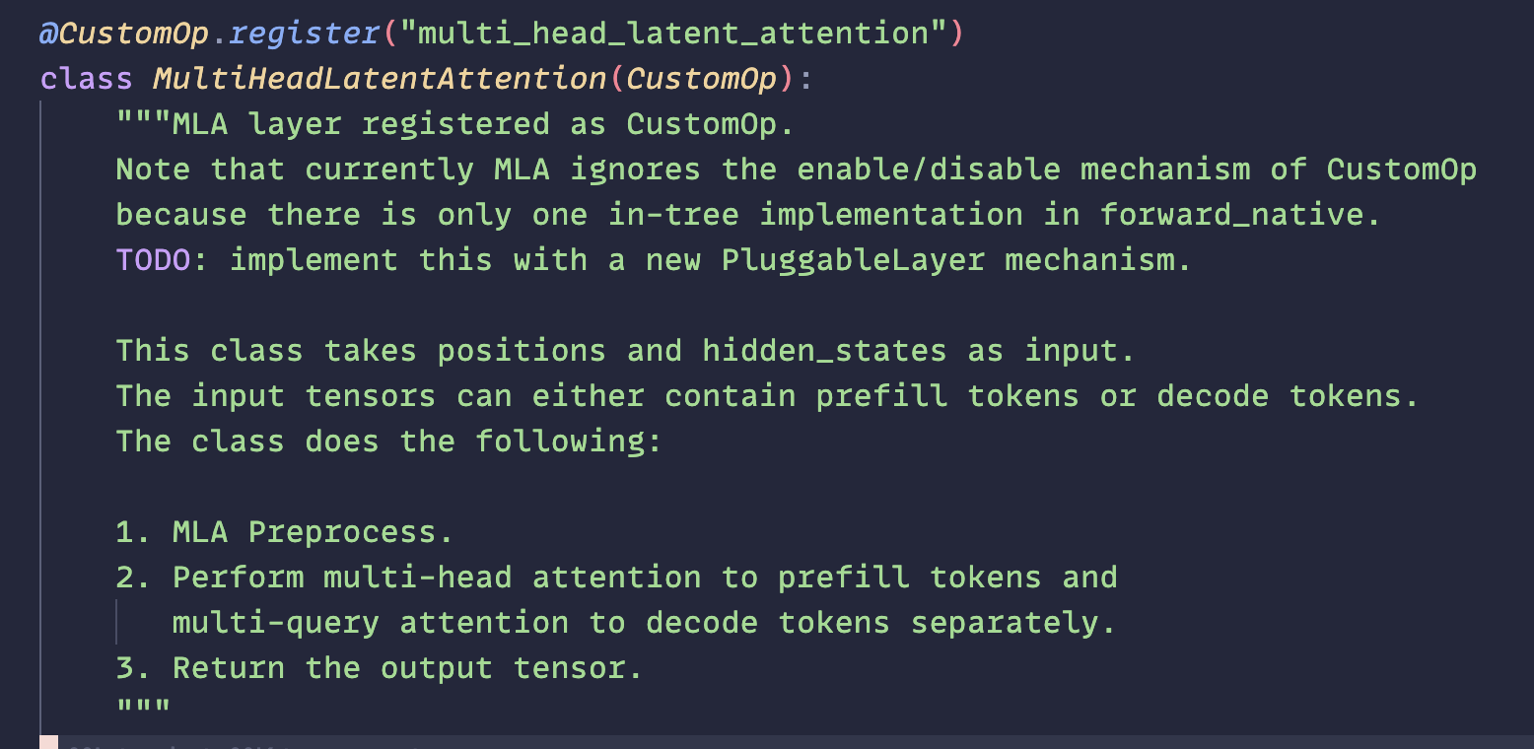
- Decode 阶段通常采用 MQA 形态。 每个请求每步只有一个或少量新 Query,却需要访问较长的历史 KV。通过矩阵吸收,Query 可以直接与共享 latent 计算注意力,Value 的上投影则移到加权求和之后,从而避免显式展开历史多头 K/V,降低访存压力。即使核心注意力的计算量有所增加,也可能获得更好的实际性能。
vLLM 就是这样实现的。
2.6 问题:TP 实现的困境
说了这么多好处,那坏处呢。坏处就是在实现 TP 的时候很低效。因为KVCache 的使用的 Latent $C$ 之后才能产生 MultiHead 的 KV,因此在实现 TP 的时候每个GPU 上都需要保持一个完整的 KVCache7,相当于浪费 (TP_SIZE - 1) * KVCache By Single Token 。 因此在 DeepSeek 的部署中往往使用 dp-attention 的方式去部署,这样吞吐会很高,同时也可以更高效实现推理。
3. 小结
MLA的诞生是DeepSeek在MHA的基础上对KVCache/计算量与效果逐步Tradeoff的结果。尤其是是因为 MHA/MQA 的两种 MLA 的形式更是 DeepSeek 工程实践的最佳体现。但是也有一些小问题比如说 TP 实现困难。总之瑕不掩瑜,个人觉的也算是 FullAttention 时代的最极致的设计了。
augmented-rnns 非常经典一个讲解 RNN vs Transformer 的 blog: https://distill.pub/2016/augmented-rnns/ ↩︎ ↩︎
Attention is all you need: https://arxiv.org/pdf/1706.03762 ↩︎
GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints ↩︎
Layer Fusion Catalog https://docs.nvidia.com/deeplearning/tensorrt/latest/performance/fusion-catalog.html ↩︎
为什么会损失精度:因为浮点数不支持交换律,两个有理数的交换律在数学上是完全成立的,但是在浮点数表示上并不成立。读者可以自行在 Python 尝试计算这个表达式 (0.1+1e20)-1e20≠0.1+(1e20-1e20) 这种因为计算顺序引入的误差也会导致意想不到的误差。 浮点的误差 case 来源于 Defeating Nondeterminism in LLM Inference ↩︎
苏剑林. (May. 13, 2024). 《缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA 》[Blog post]. Retrieved from https://spaces.ac.cn/archives/10091 ↩︎
实现 TP 的时候一般的工程实现是对着 Head 做矩阵切分。 ↩︎